Agent Skills і SKILL.md: пишемо, індексуємо, перевіряємо
Напишіть SKILL.md для Agent Skills на своєму сайті, додайте його до /.well-known/agent-skills/index.json і перевірте sha256-digest одним скриптом на curl.
Agent Skill для сайту — це файл SKILL.md, який пояснює агенту, як користуватися вашим сайтом чи API, плюс запис у /.well-known/agent-skills/index.json, за яким агент знаходить файл і перевіряє, що він не змінився. Формат файлу взято з agentskills.io. Індекс виявлення — окрема чернетка з п'ятьма обов'язковими полями на навичку, і найлегше непомітно помилитися в полі digest: SHA-256 від точних байтів, які ви віддаєте.
Навички — останній шар стека готовності. Спершу агент добирається до ваших сторінок і читає їх, потім знаходить, що можна викликати, потім дізнається, як цим правильно користуватися. Як зробити сайт доступним для виклику агентами малює всю карту: MCP Server Card каже, куди підключатися, каталог API перелічує ваші API.
Ця стаття — докладний розбір саме цього шару. Одразу застереження: формат SKILL.md підтримують широко, а індекс для сайтів з'явився пізніше, підтримується слабше й досі залишається чернеткою. Підтвердити я зміг одного відкритого клієнта, який його читає.
Ключові висновки
- Навичка — це
SKILL.mdз YAML front-matter:name(до 64 символів, малі літери, цифри, дефіси) іdescription(до 1 024 символів), де сказано, що навичка робить і коли її застосовувати (специфікація Agent Skills).- Виявлення на сайтах — чернетка, а не RFC IETF: Agent Skills Discovery 0.2.0, оновлено 12 березня 2026 року. Індекс перелічує навички з полями
name,type,description,urlіdigest(cloudflare/agent-skills-discovery-rfc).digest— цеsha256:і хеш сирих байтів артефакту. Клієнт МАЄ (MUST) його перевірити й НЕ ПОВИНЕН використовувати файл у разі розбіжності (та сама чернетка).- Найдешевший спосіб уникнути дрейфу — рахувати digest від тих самих байтів, які віддає маршрут. Так робить aiSiteReady, і я перевірив результат ззовні через
shasum.- Перевірка
agent_skillsв aiSiteReady валідує форму індексу та формат digest.SKILL.mdвона не завантажує, тож скрипт перевірки нижче запускайте самі.
Що таке Agent Skill і чим він відрізняється від документації API?
Agent Skill — це тека з обов'язковим файлом SKILL.md (YAML front-matter плюс інструкції в Markdown) та необов'язковими каталогами scripts/, references/ і assets/ (специфікація Agent Skills). На відміну від документації API, яка каже, що існує і де, навичка каже агенту, що робити. Формат спочатку розробила Anthropic і випустила як відкритий стандарт; у списку клієнтів на agentskills.io тепер понад сорок продуктів, що його підтримують.
Масштабується він завдяки поступовому завантаженню. На старті агент читає лише name і description кожної навички — близько 100 токенів на навичку. Коли завдання підходить, він завантажує тіло SKILL.md — до 5 000 токенів. Додані файли вантажаться, лише якщо на них посилаються інструкції (документація Anthropic).
Цим навичка й відрізняється від документації API. OpenAPI і Server Card кажуть агенту, що існує і де. Навичка каже, що робити: коли вона застосовна, які виклики й у якому порядку робити та як діяти під час збою. Власного транспорту й ендпоінта вона не оголошує.
| Поле front-matter | Правило |
|---|---|
name (обов'язкове) | До 64 символів; малі літери, цифри, дефіси; без дефіса на початку та в кінці й без подвійного; має збігатися з назвою батьківської теки |
description (обов'язкове) | Від 1 до 1 024 символів; каже, що робить навичка і коли її застосовувати |
Необов'язкові поля — license, compatibility, metadata та експериментальне allowed-tools. Платформа Anthropic додає два правила: в обов'язкових полях не має бути XML-тегів, а в імені — слів anthropic і claude. Оскільки ім'я має збігатися з текою, навичка сайту scan-url природно лежить за адресою /.well-known/agent-skills/scan-url/SKILL.md.
Як агенти знаходять навички на сайті?
Вони запитують один JSON-файл за well-known-шляхом. Механізм описано в чернетці Agent Skills Discovery в GitHub-репозиторії Cloudflare: видавець МАЄ (MUST) віддавати /.well-known/agent-skills/index.json зі списком усіх навичок (cloudflare/agent-skills-discovery-rfc). Станом на 2 жовтня 2026 року це версія 0.2.0, опублікована 17 січня 2026 і оновлена 12 березня 2026. Вона спирається на RFC 8615, але не є документом IETF, а запису agent-skills у реєстрі well-known URI від IANA, оновленому 16 вересня 2026 року, я не знайшов. Деталі можуть змінитися.
Ось реальний індекс aiSiteReady, знятий із продакшену 2 жовтня 2026 року.
{
  "$schema": "https://schemas.agentskills.io/discovery/0.2.0/schema.json",
  "skills": [
    {
      "name": "scan-url",
      "type": "skill-md",
      "description": "Submit a public URL and receive an Agent Readiness Score (0–100) with per-check evidence and prioritized, localized remediation guidance for AI-agent and AI-search readiness.",
      "url": "https://www.ai-siteready.com/.well-known/agent-skills/scan-url/SKILL.md",
      "digest": "sha256:1d7a33bcc768060bbba4328bec09637e6dcc043ada3c85f19f758879bde54ffb"
    }
  ]
}
$schema — непрозорий ідентифікатор версії. Клієнт має попередити про незнайоме значення й пропустити індекс, а за відсутності $schema вважати індекс старим форматом 0.1.0. Кожен запис у skills мусить містити всі п'ять полів.
| Поле запису | Правило з чернетки |
|---|---|
name | Ті самі правила, що й для імені в SKILL.md |
type | skill-md для одного файлу або archive для .tar.gz чи .zip із SKILL.md у корені; невідомі типи клієнт пропускає |
description | До 1 024 символів; СЛІД (SHOULD) збігатися з описом із front-matter |
url | Повний URL, шлях від кореня сайту або шлях, відносний до URL індексу |
digest | sha256: і 64 малих hex-символи від сирих байтів артефакту |
Рядок $schema порівнюють, а не завантажують. Чернетка каже, що він не мусить відкриватися, і хост schemas.agentskills.io під час моєї перевірки 2 жовтня 2026 року не мав DNS-запису.
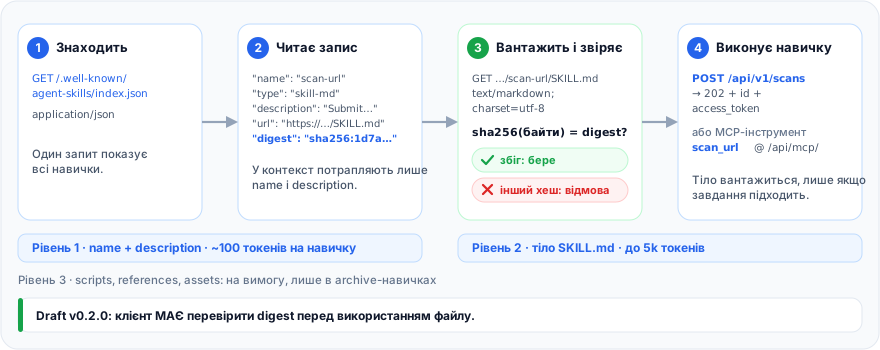
Хто насправді читає індекс? Підтримка нерівномірна. Відкритий інсталятор skills від Vercel Labs реалізує версію 0.2.0: npx skills add https://your-domain читає індекс, завантажує всі перелічені навички, звіряє хеш кожної з digest і лише потім дає обрати, що встановити (вихідний код, розбір Evil Martians, серпень 2026). Деінде підтримка слабша: травневий запит 2026 року на завантаження навичок із well-known-URL у Claude Code закрили через місяць як неактивний, так і не реалізувавши.
Як написати SKILL.md, яким агенти справді користуються?
Почніть з description: це все, що агент бачить, перш ніж вирішити. Посібник Anthropic радить писати, що навичка робить і коли її застосовувати, від третьої особи та з конкретними ключовими словами, й застерігає від розмитих на кшталт «Helps with documents» (Skill authoring best practices).
Для сайту назвіть ситуацію користувача: «Looks up the status of an order by order number. Use when a user asks where an order is, whether it shipped, or when it will arrive.»
Далі в тілі потрібно п'ять розділів у такому порядку.
| Розділ | Що в ньому | Навіщо |
|---|---|---|
| When to use | Ситуації словами користувача | Підтверджує збіг |
| How to invoke | Точні ендпоінти, методи, параметри, приклад запиту | Агент не вгадає ваш API |
| Output | Форма результату | Не дає вигадувати поля |
| Errors and limits | Кожна помилка, наступний крок, ліміти | Не дає піти в цикл повторів |
| Scope and safety | Чого навичка не робить; жодних секретів | Текст потрапляє просто в контекст агента |
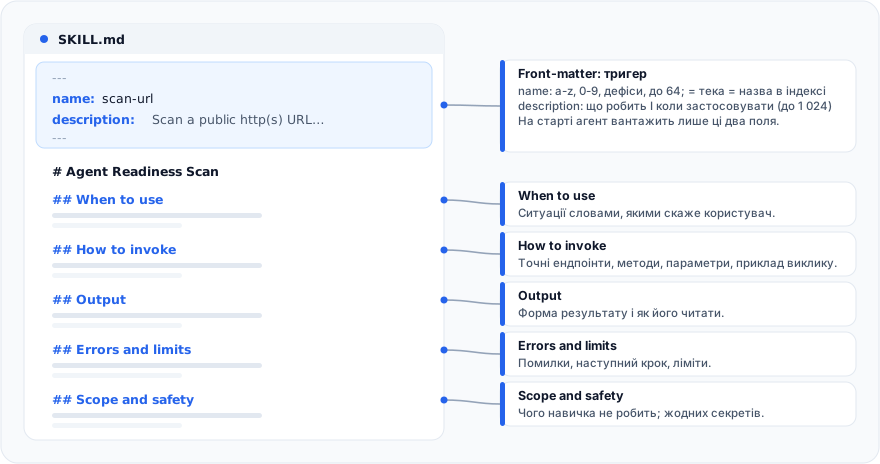
Останній рядок важливіший, ніж здається. SKILL.md потрапляє просто в контекст агента, тому чернетка попереджає, що шкідливий файл може підкинути інструкції, а клієнтам радить вантажити навички лише з довірених (allowlist) джерел (чернетка, розділ Security considerations).
Пишіть лише про дії вашого сайту, ніколи не просіть агента кудись надсилати дані користувача й прямо кажіть, що виходить за межі навички. Там же сказано, що клієнтам НЕ МОЖНА (SHALL NOT) за замовчуванням виконувати файли з scripts/, тож навичка для сайту не повинна від скриптів залежати. Беріть один файл skill-md, коротший за 500 рядків (agentskills.io).
Ось front-matter і перший розділ власної навички scan-url з aiSiteReady — у тому вигляді, як вона віддається, без вступного абзацу.
---
name: scan-url
description: Scan a public http(s) URL for AI-agent and AI-search readiness and return an Agent Readiness Score (0-100) with per-check evidence and prioritized, localized remediation guidance across discoverability, content accessibility, bot governance, protocol/API discovery, and commerce.
license: Apache-2.0
---

# Agent Readiness Scan

## When to use

- A user asks whether a site is discoverable, parseable, or usable by AI agents and
  AI-search crawlers.
- You need a structured readiness report (robots/sitemap/llms.txt, structured data,
  bot governance, MCP/A2A/API discovery, commerce signals) for a URL.
Звіривши її зі своїм же чек-листом, я знайшов три прогалини:
- В описі сказано, що навичка робить, але немає звороту «використовуйте, коли»: ця фраза лежить у тілі, яке агент читає вже після рішення.
- REST-варіант радить «poll the returned report path», але відповідь
202наPOST /api/v1/scansміститьidтаaccess_token, а не шлях, і непублічний звіт без токена не прочитати. - Розділу з помилками немає.
Ось що я б додав, узявши коди статусів із живого документа OpenAPI.
### Option B - REST API

1. `POST /api/v1/scans` with {"url": "https://example.com", "profile": "all", "locale": "en"}.
   The `202` response carries `id` and `access_token`.
2. Poll `GET /api/v1/scans/{id}` with the header `X-Scan-Access-Token: <access_token>`
   until `status` is `succeeded` or `failed`.
3. Read `GET /api/v1/scans/{id}/report.json` with the same header.

## Errors and limits

- `400` `invalid_scan_url`: the URL is not a public http(s) address. Ask for another one.
- `409` `idempotency_conflict`: the same `Idempotency-Key` was sent with a different body.
- `422` `validation_error` or `invalid_check_selection`: the request body is invalid. Fix it; do not resend it unchanged.
- `429` `rate_limited`: wait the number of seconds in `Retry-After`, then retry once.
- `503` `queue_unavailable`: try again later; do not loop.
- Only public pages are scanned: no logins, no remote JavaScript.
Якщо ліміти описані в навичці, публікуйте їх і заголовками: див. заголовки RateLimit-Policy для ШІ-агентів.
Як віддавати індекс і SKILL.md?
Як статичні, публічні файли, придатні для кешування, з чесними медіатипами. Чернетка конкретна щодо того, що сервер МАЄ (MUST) і що СЛІД (SHOULD) робити (чернетка, розділ HTTP Considerations); в останньому стовпці — те, що продакшен-маршрути aiSiteReady повернули 2 жовтня 2026 року.
| Ресурс | Вимога | aiSiteReady |
|---|---|---|
| Медіатип індексу | MUST бути application/json | application/json; charset=utf-8 |
Медіатип SKILL.md | MUST бути text/markdown або text/plain | text/markdown; charset=utf-8 |
| Методи | MUST підтримувати GET і HEAD | Лише GET станом на 2 жовтня 2026 року; обидва — після виправлення (див. нижче) |
| Відсутня навичка | MUST повернути 404 | 404 із JSON-тілом |
| Кешування | SHOULD задати Cache-Control | public, max-age=3600 |
| CORS | SHOULD задати заголовки для браузерних споживачів | Не задано |
HTTP/2 200
content-type: application/json; charset=utf-8
cache-control: public, max-age=3600

HTTP/2 200
content-type: text/markdown; charset=utf-8
cache-control: public, max-age=3600
vary: Accept-Encoding
Поле url може бути повним URL, шляхом від кореня сайту (розв'язується відносно origin індексу) або шляхом, відносним до каталогу індексу. aiSiteReady публікує повні URL, і в цього є ціна.
Генератор індексу бере origin із NUXT_PUBLIC_SITE_URL, а якщо змінну не задано, відкочується до dev-origin localhost:5173. Сканер відхиляє такий URL — у localhost немає крапки, а 5173 не порт 80 чи 443, — тож продакшен-деплой, де про змінну забули, публікує індекс, який перевірка оцінює як PARTIAL. Шляхи від кореня обійшли б проблему, і інсталятор, чий код я читав, розв'язує їх через new URL(entry.url, indexUrl), але перевіряйте кожного клієнта, який вам важливий.
Для статичного сайту фреймворк не потрібен. Цей скрипт копіює кожну навичку побайтово в публічну теку й пише індекс за тими самими байтами.
// node build-skills-index.mjs https://example.com
// Читає skills/<name>/SKILL.md, копіює кожен файл побайтово в public/
// і пише індекс, digest якого рахується за цими самими байтами.
import { createHash } from "node:crypto";
import { mkdirSync, readFileSync, readdirSync, writeFileSync } from "node:fs";
import { join } from "node:path";

const origin = (process.argv[2] ?? "").replace(/\/$/, "");
if (!origin.startsWith("https://")) throw new Error("usage: node build-skills-index.mjs https://example.com");

const out = "public/.well-known/agent-skills";
const skills = [];
const names = readdirSync("skills", { withFileTypes: true })
  .filter((d) => d.isDirectory()) // пропускаємо випадкові файли на кшталт .DS_Store
  .map((d) => d.name)
  .sort();
for (const name of names) {
  const bytes = readFileSync(join("skills", name, "SKILL.md")); // сирі байти, без перекодування
  const front = /^\uFEFF?---\r?\n([\s\S]*?)\r?\n---/.exec(bytes.toString("utf8"))?.[1] ?? "";
  const field = (key) =>
    new RegExp(`^${key}:\\s*(.+)$`, "m").exec(front)?.[1].trim().replace(/^(["'])(.*)\1$/, "$2");
  if (field("name") !== name) throw new Error(`${name}: front-matter name must equal the folder name`);
  const description = field("description");
  if (!description || /^[>|]/.test(description)) throw new Error(`${name}: front-matter needs a one-line description`);

  mkdirSync(join(out, name), { recursive: true });
  writeFileSync(join(out, name, "SKILL.md"), bytes); // віддаємо рівно те, що хешували
  skills.push({
    name,
    type: "skill-md",
    description, // той самий текст, що у front-matter: чернетка каже, що він SHOULD збігатися
    url: `${origin}/.well-known/agent-skills/${name}/SKILL.md`,
    digest: `sha256:${createHash("sha256").update(bytes).digest("hex")}`,
  });
}

const schema = "https://schemas.agentskills.io/discovery/0.2.0/schema.json";
writeFileSync(join(out, "index.json"), `${JSON.stringify({ $schema: schema, skills }, null, 2)}\n`);
console.log(`wrote ${skills.length} skill(s) to ${out}`);
Перевірте content-type, який ваш хостинг віддає для .md-файлів. У стандартному nginx немає MIME-типу для md, і він віддає application/octet-stream, порушуючи MUST із чернетки; додайте types { text/markdown md; } у блок http (у блоці server директива замінює всю таблицю типів, разом із JSON). І переконайтеся, що відсутня навичка дає 404: односторінковий застосунок, який на будь-який невідомий шлях відповідає своєю HTML-оболонкою з кодом 200, залюбки «віддасть» відсутній SKILL.md.
Як не допустити розбіжності digest із файлом, що віддається?
Рахуйте його від тих самих байтів, які віддаєте, і на тому самому кроці. Digest — це sha256: і хеш сирих байтів артефакту, а клієнт МАЄ (MUST) перевірити його після завантаження й НЕ ПОВИНЕН використовувати файл у разі розбіжності (чернетка, розділ Integrity). Інсталятор Vercel Labs робить саме це: fetchArtifactSkillByEntry хешує завантажені байти й повертає null, якщо результат відрізняється від entry.digest, а fetchAllSkills відфільтровує такі null. Навичка мовчки зникає зі списку, а помилки про digest ви не побачите.
Тож дрейф — тиха поломка: правите SKILL.md, забуваєте перезібрати індекс — і клієнти, що дотримуються специфікації, перестають використовувати навичку, а ви не побачите жодної помилки. Хешуйте розпаковане тіло, а не gzip-передачу. Усе, що переписує байти вже після хешування, наприклад конвертація переносів рядків або проксі, що вставляє футер, теж ламає збіг.
aiSiteReady усуває проблему структурно. Текст навички живе в одній TypeScript-константі. Маршрут повертає цю константу, а digest рахується від неї під час завантаження модуля. Другої копії, яку можна відредагувати окремо, просто немає.
// константа навички та її digest (скорочено)
import { createHash } from "node:crypto";

export const SCAN_URL_SKILL_MD = `---
name: scan-url
description: Scan a public http(s) URL …
---
…`;

export const SCAN_URL_SKILL_DIGEST = `sha256:${createHash("sha256")
  .update(SCAN_URL_SKILL_MD, "utf8")
  .digest("hex")}`;
// обробник маршруту SKILL.md (скорочено)
export default defineReadOnlyHandler((event) => { // однаково для GET і HEAD; 405 на інші методи
  setResponseHeader(event, "Content-Type", "text/markdown; charset=utf-8");
  return SCAN_URL_SKILL_MD; // рівно та константа, від якої пораховано digest
});
Я перевірив це ззовні 2 жовтня 2026 року. Продакшен-файл важить 2 476 байтів, а shasum -a 256 друкує 1d7a33bc…bde54ffb — digest з індексу. Тіло навички до того ж відносне до origin: у ньому шляхи на кшталт /api/mcp/, а не повні URL, тож байти, а з ними й digest, однакові на будь-якому домені деплою.
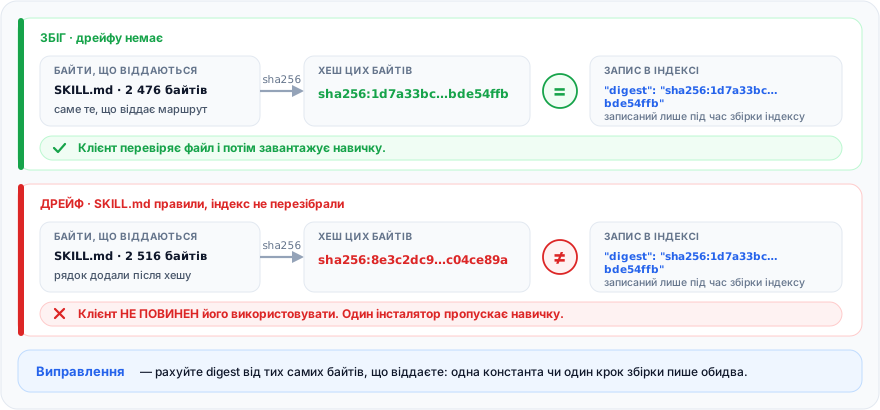
Якщо хостити навички там, де ви нічого не контролюєте, наприклад за сирими посиланнями GitHub, ця гарантія втрачається: зміни в апстримі змінюють байти під уже опублікованим digest. Правило Evil Martians — писати де завгодно, а публікувати з місця, яке ви контролюєте (Evil Martians).
Як перевірити індекс Agent Skills?
Перевіряйте три речі: індекс парситься й має правильну форму, кожен url віддає правильний медіатип, а кожен digest збігається з байтами. Ручний варіант — три команди curl.
# 1. заголовки й тіло індексу
curl -sSi https://example.com/.well-known/agent-skills/index.json | head -20
# 2. усі навички та заявлені digest
curl -sS https://example.com/.well-known/agent-skills/index.json | jq -r '.skills[] | [.name, .digest] | @tsv'
# 3. реальний хеш навички, що віддається, щоб порівняти на око
curl -sS https://example.com/.well-known/agent-skills/scan-url/SKILL.md | shasum -a 256
Для CI все це робить один скрипт. Йому потрібні curl, jq і shasum (на Linux без нього підставте sha256sum), і за будь-якої помилки він завершується з ненульовим кодом.
#!/usr/bin/env bash
# usage: ./check-skills.sh https://example.com
set -euo pipefail
ORIGIN="${1:?usage: check-skills.sh https://example.com}"
ORIGIN="${ORIGIN%/}"
INDEX="$ORIGIN/.well-known/agent-skills/index.json"
SCHEMA="https://schemas.agentskills.io/discovery/0.2.0/schema.json"
bad=0
ok()   { printf 'ok    %s\n' "$*"; }
fail() { printf 'FAIL  %s\n' "$*"; bad=1; }
tmp="$(mktemp)"; trap 'rm -f "$tmp"' EXIT

# 1. Індекс: статус, медіатип, підтримка HEAD, $schema
meta="$(curl -sS -o "$tmp" -w '%{http_code} %{content_type}' "$INDEX")"
[[ "$meta" == 200\ application/json* ]] && ok "index: GET 200, ${meta#* }" || fail "index: GET -> $meta"
[[ "$(curl -sS -I -o /dev/null -w '%{http_code}' "$INDEX")" == 200 ]] \
  && ok "index: HEAD 200" || fail "index: HEAD is not 200 (the draft says servers MUST support HEAD)"
body="$(cat "$tmp")"
jq -e --arg s "$SCHEMA" '."$schema" == $s' <<<"$body" >/dev/null \
  && ok "index: \$schema is the 0.2.0 URI" || fail "index: missing or unexpected \$schema"
jq -e '.skills | type == "array" and length > 0' <<<"$body" >/dev/null 2>&1 \
  && ok "index: skills[] has entries" || fail "index: skills[] is missing or empty"

# 2. Кожен запис: поля, URL, медіатип, name у front-matter і digest
while read -r entry; do
  name="$(jq -r '.name // ""' <<<"$entry")"; url="$(jq -r '.url // ""' <<<"$entry")"
  want="$(jq -r '.digest // ""' <<<"$entry")"
  type="$(jq -r '.type // ""' <<<"$entry")"
  jq -e '.description | type == "string" and length > 0 and length <= 1024' <<<"$entry" >/dev/null \
    || fail "$name: description is missing or longer than 1,024 characters"
  [[ "$type" == skill-md ]] || { fail "$name: type is '$type'; this script verifies skill-md entries only"; continue; }
  [[ "$name" =~ ^[a-z0-9]+(-[a-z0-9]+)*$ && ${#name} -le 64 ]] || fail "$name: invalid name"
  [[ "$want" =~ ^sha256:[0-9a-f]{64}$ ]] || fail "$name: digest is not sha256:<64 lowercase hex>"
  case "$url" in https://*|http://*) ;; /*) url="$ORIGIN$url" ;; *) url="$ORIGIN/.well-known/agent-skills/$url" ;; esac
  [[ "$url" == https://* && "$url" != *localhost* ]] || { fail "$name: url is not a public https URL ($url)"; continue; }

  meta="$(curl -sS -o "$tmp" -w '%{http_code} %{content_type}' "$url")"
  [[ "$meta" == 200\ text/markdown* || "$meta" == 200\ text/plain* ]] \
    && ok "$name: GET 200, ${meta#* }" || fail "$name: GET -> $meta"
  got="sha256:$(shasum -a 256 "$tmp" | cut -d' ' -f1)"
  [[ "$got" == "$want" ]] && ok "$name: digest matches the served bytes" \
    || fail "$name: digest drift - index says $want, served bytes hash to $got"
  head -n 10 "$tmp" | tr -d '\r' | grep -qx "name: $name" \
    && ok "$name: front-matter name matches" || fail "$name: front-matter name differs from the index"
done < <(jq -c '.skills[]?' <<<"$body" 2>/dev/null)

exit "$bad"
Запущений на продакшен-сайті aiSiteReady 2 жовтня 2026 року, він вивів ось це.
ok    index: GET 200, application/json; charset=utf-8
FAIL  index: HEAD is not 200 (the draft says servers MUST support HEAD)
ok    index: $schema is the 0.2.0 URI
ok    index: skills[] has entries
ok    scan-url: GET 200, text/markdown; charset=utf-8
ok    scan-url: digest matches the served bytes
ok    scan-url: front-matter name matches
Ця помилка була справжньою, і вона була нашою. Станом на 2 жовтня 2026 року наші well-known-маршрути були обробниками лише для GET, і запит HEAD до них повертав 404, тоді як чернетка вимагає підтримувати обидва методи. Клієнт, який перед завантаженням шле HEAD, неправильно оцінив би наш сайт. Виправлення виявилося невеликим: файли маршрутів втратили суфікс .get, і один обробник тепер відповідає на GET і HEAD з однаковими статусом і заголовками, тож цей рядок має вигляд ok index: HEAD 200. Помітив я помилку лише тому, що написав цей скрипт, — тож запустіть свій, перш ніж довіряти власному налаштуванню.
Які помилки ламають індекс Agent Skills?
Найчастіше індекс ламають дрейф digest, розмитий description і localhost в url, і майже всі такі поломки тихі: клієнт пропускає навичку або сканер знижує оцінку перевірки. Ось що я б перевірив насамперед.
| Помилка | Що відбувається | Як виправити |
|---|---|---|
| Дрейф digest | Клієнти, що дотримуються специфікації, відмовляються від навички, а ви нічого не бачите | Рахуйте digest від байтів, що віддаються |
Розмитий description | Агент ніколи не обере навичку | Скажіть, що вона робить, і «Use when» |
| Навичка, що вимагає логіна | Агент застрягає на першому кроці | Опишіть, як отримати доступ, або не публікуйте |
localhost чи dev-порт у url | Наша перевірка відхиляє URL (ім'я без крапки або порт не 80/443) і дає PARTIAL; staging-хост перевірку проходить, але відправляє агентів на staging | Задайте публічний origin або використовуйте шляхи від кореня |
HTML-оболонка з кодом 200 замість відсутнього файлу | Клієнт без перевірки завантажить HTML як інструкції | Повертайте 404 |
Немає $schema або вигаданий | Інсталятор, чий код я читав, вважає відсутній старим 0.1.0, а незнайомий пропускає; без нього наша перевірка дає PARTIAL, а будь-який непорожній рядок, навіть вигаданий, приймає | Скопіюйте URI 0.2.0 точно |
Стара форма 0.1.0 або шлях /.well-known/skills/ | Наша перевірка дивиться лише новий шлях | Перейдіть на agent-skills/ з type, url, digest |
| Опис в індексі відрізняється від front-matter | Порушує SHOULD; агент бачить дві версії | Генеруйте обидва з одного джерела |
Останній рядок — ще одне зізнання. Наш індекс бере опис із A2A Agent Card, а у front-matter SKILL.md стоїть інша, довша фраза. Обидві точні, але чернетка каже, що їм СЛІД (SHOULD) збігатися. Скрипт збірки вище обходить проблему: він читає опис прямо з front-matter.
Як aiSiteReady перевіряє індекс Agent Skills?
Перевірка agent_skills в aiSiteReady робить один запит до /.well-known/agent-skills/index.json і валідує його за Agent Skills Discovery 0.2.0: структуру, п'ять полів і формат digest, але не сам SKILL.md, що віддається. Решту покриває ваш скрипт. Вона входить до категорії Protocol/API поруч із перевірками MCP Server Card та каталогу API, а аудит за 30 хвилин показує, яке місце вона займає в повному аудиті.
| Статус | Умова |
|---|---|
| PASS | $schema оголошено, content type — JSON, і є щонайменше один запис із валідними name, type, description, url та digest |
| PARTIAL | Валідні записи є, але немає $schema або індекс віддано з не-JSON типом на кшталт text/plain; записи є, але жоден не валідний; skills відсутній чи порожній; або JSON не парситься |
| UNKNOWN | Індекс не вдалося безпечно завантажити; 403 чи 429 вважається блокуванням, а не вердиктом |
| FAIL | Індексу немає: 404 чи інший код помилки, крім 403/429, або HTML-сторінка (оболонка SPA чи JSON з типом text/html) замість JSON |
Чотири обмеження, які варто знати:
- Перевірка робить один запит і ніколи не завантажує
SKILL.md, тож валідує формат digest, але не впіймає дрейф; для цього й потрібен ваш скрипт. - Вона дивиться лише well-known-шлях, без пошуку через заголовок
Link. - Категорія Protocol/API вимкнена в профілі Контентний сайт, тож перевірка враховується лише в типовому профілі Усі перевірки та в профілях API/застосунок і Інтернет-магазин.
- URL записів мають бути абсолютними http(s)-URL (або розв'язуватися в такий відносно URL індексу) з доменним ім'ям, що містить крапку, і портом 80 чи 443. Перевірка їх не резолвить і не завантажує, тож
http://localhost:5173/…не проходить, а staging-хост чи приватна IP-адреса пройдуть.
Скільки важить категорія Protocol/API (там вона називається «Протоколи») у кожному профілі, показано на сторінці методології.
Запустіть безкоштовне сканування, щоб побачити, чи знаходить агент ваш індекс навичок, які записи проходять перевірку і що виправити насамперед — англійською, українською чи російською. А повний набір шарів починається зі статті про те, що означає готовність до ШІ-агентів.
Якщо коротко: навичка — це SKILL.md, де сказано, коли її застосовувати і що саме викликати; індекс — п'ять полів на запис; а digest треба рахувати від тих байтів, які ви віддаєте. Пишіть опис як тригер, генеруйте індекс із файлів і запускайте скрипт перевірки на кожному релізі.
IMozz має 20 років у розробці ПЗ, а останній рік будує продукти за допомогою LLM. Він розвиває aiSiteReady, сканер лише для читання, що перевіряє, чи може ШІ-агент прочитати й викликати сайт. Сканер серверно рендерить власний контент як робочий приклад.