Аудит готовності до ШІ-агентів: перевірка сайту за 30 хвилин
Аудит готовності до ШІ-агентів за 30 хвилин: шість блоків curl-команд (доступ, контент, виявлення, дані, API, правила) і один скрипт на всі перевірки.
Аудит готовності до ШІ-агентів для свого сайту займає близько 30 хвилин перевірок: шість п'ятихвилинних блоків, один термінал і кілька команд curl, які покажуть, чи можуть ШІ-агенти дістатися до сайту, прочитати його, знайти, зрозуміти й викликати. Оцінка результатів і вибір, що виправляти, заберуть ще близько 10 хвилин.
Кожна команда нижче справжня. Я прогнав їх усі на нашому робочому сайті www.ai-siteready.com 2 і 3 жовтня 2026 року, а виводи — це скорочені копії того, що повернулося.
Сканер автоматизує все це, але один раз пройти руками корисно: видно, як кожен сигнал виглядає на рівні HTTP, і автоматичному звіту легше довіряти. Блоки йдуть у тому порядку, в якому бот зустрічає ваш сайт: спершу доступ, бо решта не має значення, якщо файрвол відхиляє бота, а виклик наприкінці, бо більшості сайтів він поки не потрібен. Саму ідею стека пояснює стаття що таке готовність до ШІ-агентів.
Ключові висновки
- Аудит складається з шести блоків (доступ, читання, виявлення, розуміння, виклик, правила). Разом вони зачіпають усі 21 перевірку сканера aiSiteReady.
- Починайте з доступу й читання. Бот, що отримав 403 або порожню JavaScript-оболонку, решти не побачить, а аналіз Vercel від грудня 2024 року показав, що краулери OpenAI, Anthropic і Perplexity не рендерять JavaScript (Vercel).
- У ранніх блоках більшість сайтів проходить, у пізніх — майже ніхто. Cloudflare у квітні 2026 року просканувала 200 000 найпопулярніших доменів:
robots.txtє в 78%, близько 4% оголошують уподобання щодо ШІ, а Markdown-узгодження проходять 3,9% (Cloudflare).- Не всі промахи рівнозначні. Google пише, що спеціальні файли для ШІ не потрібні, а Google Search ігнорує
llms.txt(Google). Пріоритизуйте за впливом і зусиллями.- Ручний аудит — це знімок. Автоматизуйте його, коли шаблонів багато або ви часто випускаєте релізи.
Що входить у 30-хвилинний аудит готовності до ШІ-агентів?
Шість блоків, кожен націлений на свій тип збою. aiSiteReady групує перевірки в п'ять категорій: Видимість, Доступність контенту, Правила для ботів, Protocol/API, Комерція. Аудит проходить крізь них у тому порядку, в якому краулер зустрічає сайт, тому одна категорія може розтягнутися на два блоки.
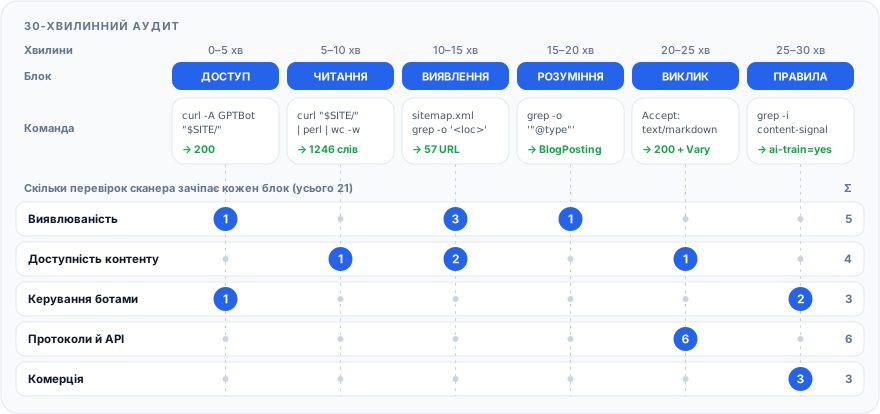
Потрібні curl і perl, вони є в macOS і в більшості дистрибутивів Linux. Підставте в змінну свій сайт і тільки свій: далі команди надсилають user agent краулерів, і це нормально для перевірки власних правил, але не для чужого сервера.
Перевірки сторінок запускайте на головній і на одному URL кожного шаблону, наприклад статті чи картки товару: проблема часто живе лише в одному шаблоні. Другий рядок нижче проходить за редиректами, тож голий домен або адреса з http:// зводиться до того origin, який справді відповідає.
export SITE=https://www.example.com    # ваш сайт, без слеша в кінці
SITE=$(curl -sS -L -o /dev/null -w '%{url_effective}' "$SITE/" | sed -E 's#^(https?://[^/]+).*#\1#')    # apex -> www, http -> https
hdr() { curl -sS -D - -o /dev/null "$@" | tr -d '\r'; }    # GET, друкуємо лише заголовки
Як перевірити, що ШІ-боти можуть дістатися до вашого сайту? (хвилини 0–5)
Запросіть головну сторінку й robots.txt як зазвичай, потім повторіть запит головної з user agent ШІ-краулерів. Кожна відповідь має бути звичайним 200 або відмовою, яку ви обрали свідомо.
curl -sS -o /dev/null -L -w 'status=%{http_code} redirects=%{num_redirects} time=%{time_total}s\n' "$SITE/"
curl -sS -o /dev/null -L -w 'robots.txt: %{http_code} %{content_type}\n' "$SITE/robots.txt"
for bot in GPTBot OAI-SearchBot ClaudeBot PerplexityBot; do
  printf '%-15s ' "$bot"
  curl -sS -o /dev/null -L -A "Mozilla/5.0 (compatible; $bot/1.0)" -w '%{http_code}\n' "$SITE/"
done
status=200 redirects=0 time=0.318752s
robots.txt: 200 text/plain; charset=utf-8
GPTBot          200
OAI-SearchBot   200
ClaudeBot       200
PerplexityBot   200
| Сигнал | Добре | Погано |
|---|---|---|
| Головна сторінка | 200, не більш як один редирект | 403, 429, 5xx, ланцюжок редиректів |
robots.txt | 200, text/plain, правила, які ви писали | 5xx, 429 або тайм-аут; HTML за цим шляхом |
| User agent ботів | той самий 200, що отримує браузер | 403, 429, сторінка-перевірка |
| Правила Disallow | нічого зайвого | Disallow: / для ШІ-бота |
У рядку про robots.txt прихована асиметрія. За RFC 9309, якщо файл недоступний (4xx), краулер може звертатися до будь-яких ресурсів, але якщо він недосяжний через помилку сервера чи мережі, краулер має вважати, що закрито все (RFC 9309). Google вважає будь-який 4xx, крім 429, відсутнім файлом (Google), тож 429 зараховуйте як провал. Зламаний robots.txt гірший, ніж відсутній. Тепер пошукайте суцільне блокування, яке хтось міг додати випадково:
curl -sS "$SITE/robots.txt" | tr -d '\r' | awk '{l=$0; sub(/#.*/,"",l); gsub(/[ \t]/,"",l); k=tolower(l)} k==""{next} k~/^user-agent:/{if(!g)u=""; g=1; u=u" "substr(l,12); next} {g=0} k=="disallow:/"{print substr(u,2)" -> Disallow: /"}'
На нашому сайті команда нічого не друкує, і це гарний результат. Якщо передати їй файл, що закриває навчальний краулер OpenAI, вона надрукує GPTBot -> Disallow: /. Група, у якій названо кілька ботів, виводиться одним рядком, а Disallow:/ без пробілу теж розпізнається.
Відсутність випадкового блокування ще не означає, що перевірку сканера ai_bot_rules пройдено. Їй потрібні іменовані групи для OAI-SearchBot, Claude-SearchBot і PerplexityBot плюс явний дозвіл або заборона хоча б для одного навчального краулера: GPTBot, ClaudeBot чи CCBot. Одна група User-agent: * дає в ній лише частковий результат. Команда grep -i '^user-agent' на вашому robots.txt покаже, які групи у вас є.
Цикл за user agent перевіряє лише правила, прив'язані до рядка user agent, і надсилає ім'я краулера з вашої власної IP-адреси. Файрволи фільтрують ще й за IP-адресою та за bot score, а OpenAI публікує IP-діапазони кожного краулера (OpenAI). Файрвол із захистом від ботів може заблокувати запит, який видає себе за краулер, але надходить не з його опублікованих IP-діапазонів, і водночас пропустити справжній краулер.
Тож 403 на підроблений user agent — підказка, яку треба звірити з логами файрвола, а не доказ блокування, а 200 потрібен, але недостатній. Anthropic додає, що блокування за IP може завадити її ботам узагалі прочитати robots.txt (Anthropic). Після зміни правил зачекайте: OpenAI повідомляє, що її системам може знадобитися близько 24 годин, щоб оновити результати пошуку (OpenAI).
Відповідні перевірки сканера: robots_txt і ai_bot_rules.
Чи може ШІ-агент прочитати сторінку без JavaScript? (хвилини 5–10)
Завантажте сторінку так, як це робить найпростіший краулер, без JavaScript, і порахуйте слова, що вціліли. Фільтр на perl викидає блоки script, style, template і SVG, а потім прибирає решту тегів.
curl -sS -L "$SITE/" | perl -0777 -pe 's/<(script|style|noscript|template|svg)\b.*?<\/\1>//gsi; s/<[^>]+>/ /gs' | wc -w
curl -sS -L "$SITE/" | grep -o -i -E '<(h1|h2|main|title)[ >]' | tr 'A-Z' 'a-z' | sort | uniq -c
1246
   1 <h1
   5 <h2
   1 <main
   1 <title>
Потрібні сотні слів, один h1, справжні заголовки й ваш власний текст; майже нульовий лічильник і скелет із розмітки — привід насторожитися. Я прогнав той самий фільтр на сторінці, де в body лише порожній div і тег script, тобто на класичній клієнтській оболонці, і він надрукував 0. Саме це отримує GPTBot або ClaudeBot від такої сторінки. За вимірюваннями Vercel від грудня 2024 року, винятком є Gemini та AppleBot: вони рендерять сторінки (Vercel).
Вебзастосунок за логіном покаже лише оболонку входу, і це очікувано. А великий лічильник сам по собі ще нічого не означає: якщо слова — це cookie-банери та навігація, прочитайте сам текст.
Відповідна перевірка сканера: ssr_content.
Як перевірити виявлення: від sitemap до llms.txt? (хвилини 10–15)
Переконайтеся, що бот знаходить ваші сторінки без здогадок: sitemap, на який вказує robots.txt, один canonical на сторінку, зв'язки виявлення в заголовку Link і, за бажанням, llms.txt.
curl -sS "$SITE/robots.txt" | grep -i '^sitemap:'
hdr "$SITE/sitemap.xml" | grep -i -E '^(HTTP|content-type)'
curl -sS "$SITE/sitemap.xml" | grep -o '<loc>' | wc -l
curl -sS "$SITE/" | grep -o '<link[^>]*rel="canonical"[^>]*>'
hdr "$SITE/" | grep -i '^link:'
hdr "$SITE/llms.txt" | grep -i -E '^(HTTP|content-type)'
hdr "$SITE/llms-full.txt" | grep -i -E '^(HTTP|content-type)'
Sitemap: https://www.ai-siteready.com/sitemap.xml
HTTP/2 200
content-type: application/xml; charset=utf-8
57
<link id="i18n-can" rel="canonical" href="https://www.ai-siteready.com">
link: </sitemap.xml>; rel="sitemap", </llms.txt>; rel="describedby", </site.webmanifest>; rel="manifest", </.well-known/api-catalog>; rel="api-catalog"
HTTP/2 200
content-type: text/markdown; charset=utf-8
HTTP/2 200
content-type: text/markdown; charset=utf-8
Порівняйте вивід із тим, як виглядає добрий і поганий результат:
| Сигнал | Добре | Погано |
|---|---|---|
| Sitemap | XML, ненульова кількість <loc>, указаний у robots.txt | 404, HTML-сторінка з відповіддю 200, URL зі staging-домену |
| Canonical | один абсолютний URL, що збігається зі сторінкою | відсутній, подвоєний або розходиться з sitemap |
llms.txt | 200 з text/markdown або text/plain | HTML за цим шляхом, який часто віддає маршрут-заглушка (catch-all) |
Заголовок Link — найдешевший сигнал: RFC 8288 визначає його як спосіб серіалізувати посилання в HTTP-заголовки, і кожне посилання мусить мати rel (RFC 8288). Наш заголовок вказує на sitemap, llms.txt і каталог API, і клієнтові не потрібно розбирати HTML.
З llms.txt — без ілюзій. У пропозиції обов'язковий лише H1, за ним ідуть стисле резюме в цитаті та розділи з посиланнями (llmstxt.org); це пропозиція, а не стандарт. Ahrefs з'ясував, що близько 28% зі 137 000 доменів у його даних Web Analytics публікують такий файл, а 97% цих файлів за травень 2026 року не отримали жодного запиту (Ahrefs). Публікувати його дешево, але це погана причина відкладати те, що вище в списку.
Відповідні перевірки сканера: sitemap, canonical_metadata, link_headers, llms_txt, llms_full_txt.
Чи говорять ваші структуровані дані, хто й коли це написав? (хвилини 15–20)
Виведіть типи JSON-LD із сирого HTML і перевірте, що в статті є автор і дати. У ARTICLE підставте будь-яку статтю свого сайту; у нас це була /blog/serve-markdown-to-ai-agents. Структуровані дані, які скрипт підставляє після завантаження, у цей вивід не потраплять, і в цьому весь сенс.
ARTICLE="$SITE/path/to/an/article"    # будь-яка стаття вашого сайту
curl -sS "$SITE/" | grep -o '"@type": *"[^"]*"' | sort | uniq -c
curl -sS "$ARTICLE" | grep -o -E '"(datePublished|dateModified)": *"[^"]*"|"author": *\{[^}]*\}'
  10 "@type":"Answer"
   1 "@type":"FAQPage"
   1 "@type":"ImageObject"
   1 "@type":"Offer"
   1 "@type":"Organization"
  10 "@type":"Question"
   1 "@type":"SoftwareApplication"
   1 "@type":"WebSite"
"datePublished":"2026-06-07"
"dateModified":"2026-06-07"
"author":{"@type":"Person","name":"IMozz","url":"https://github.com/i-mozz"}
На головній мають бути Organization і WebSite, а в кожній статті — BlogPosting з автором Person, datePublished і dateModified. Google називає ці три властивості рекомендованими для Article і жодну не вважає обов'язковою (Google). Шукайте порожній вивід, дати лише у видимому тексті або автора «admin». В інтернет-магазинів тут має з'явитися й Product. Для статей див. чек-лист автора, дати та JSON-LD.
Відповідна перевірка сканера: generic_structured_data.
Чи може агент викликати можливості вашого сайту? (хвилини 20–25)
Запросіть Markdown, а тоді перевірте well-known шляхи, де оголошуються агентські ендпоінти. Контентним сайтам другу половину можна проглянути: вона важлива продуктам з API чи інструментами.
hdr -H 'Accept: text/markdown' "$SITE/" | grep -i -E '^(HTTP|content-type|vary)'
for p in api-catalog agent-skills/index.json ai-catalog.json mcp/server-card.json agent-card.json \
         oauth-authorization-server oauth-protected-resource; do
  printf '%-44s ' "/.well-known/$p"
  curl -sS -o /dev/null -L -w '%{http_code} %{content_type}\n' "$SITE/.well-known/$p"
done
HTTP/2 200
content-type: text/markdown; charset=utf-8
vary: Accept-Encoding
vary: Accept
/.well-known/api-catalog                     200 application/linkset+json; charset=utf-8; profile="https://www.rfc-editor.org/info/rfc9727"
/.well-known/agent-skills/index.json         200 application/json; charset=utf-8
/.well-known/ai-catalog.json                 404 application/json
/.well-known/mcp/server-card.json            200 application/json; charset=utf-8
/.well-known/agent-card.json                 200 application/json; charset=utf-8
/.well-known/oauth-authorization-server      404 application/json
/.well-known/oauth-protected-resource        404 application/json
З Markdown потрібен text/markdown разом із Vary: Accept: так кеш не віддасть Markdown браузеру, а сам Vary: Accept-Encoding не зараховується. Якщо ви не на Cloudflare, див. Markdown без Cloudflare. Читайте результат обходу за кодом статусу, а не за типом вмісту: три наші рядки з 404 усе одно показують application/json, бо тіло помилки — JSON.
| Шлях | Що оголошує | Статус стандарту |
|---|---|---|
api-catalog | ваші API з посиланням на файл OpenAPI | RFC 9727 (RFC 9727) |
ai-catalog.json | ШІ-артефакти, зокрема MCP Server Card | чернетка; точка входу для виявлення в чернетці MCP |
mcp/server-card.json | MCP-сервер і його ендпоінт | експериментальний, не офіційне розширення; старий шлях (репозиторій MCP) |
agent-skills/index.json | навички, які може завантажити агент | Draft 0.2.0 (репозиторій специфікації) |
oauth-* | метадані OAuth-сервера й ресурсу | RFC 8414 та RFC 9728 (RFC 8414, RFC 9728) |
Тип сайту визначає, що означає 404. Сайт без OAuth-захищеного API має отримати 404 в обох рядках OAuth, і в нас так і є; сайт, де працює OAuth, має отримати 200. Сканер вважає такий 404 незастосовним, якщо не бачить ознак OAuth, але не в профілі API/застосунок: там 404 — провал навіть для сервісу, який працює лише з API-ключами.
Картка MCP переїхала. Поточна чернетка дозволяє розміщувати картку за будь-яким незарезервованим URI, рекомендує <mcp-url>/server-card і будує виявлення через /.well-known/ai-catalog.json; шлях /.well-known/mcp/server-card у ній розглянуто й не рекомендовано (discovery.md). Сканер aiSiteReady досі перевіряє старий шлях, а наш сайт поки віддає картку там само й без AI Catalog. Подробиці — у статті MCP Server Card.
digest в Agent Skills — це SHA-256, тож команда curl -sS "$SITE/.well-known/agent-skills/scan-url/SKILL.md" | shasum -a 256 має надрукувати hex-частину значення sha256: з індексу; на нашому сайті так і відбувається. Підтримка всього цього в агентів нерівномірна, а частина специфікацій — чернетки.
Відповідні перевірки сканера: markdown_negotiation, api_catalog, mcp_server_card, agent_skills, a2a_webmcp_readiness, oauth_authorization_server, oauth_protected_resource.
Які правила використання, ліміти та дані про товари ви публікуєте? (хвилини 25–30)
Останній блок: сказати агентам, що їм можна, як швидко і, якщо ви щось продаєте, що саме.
curl -sS "$SITE/robots.txt" | grep -i -E '^content-(signal|usage)'
hdr "$SITE/" | grep -i '^content-usage:' || echo 'content-usage header: none'
curl -sS -o /dev/null -w 'tdmrep: %{http_code}\n' "$SITE/.well-known/tdmrep.json"
hdr "$SITE/" | grep -i -E '^(ratelimit|ratelimit-policy|retry-after)'
curl -sS -o /dev/null -w 'ucp: %{http_code}\n' "$SITE/.well-known/ucp"
Content-Signal: search=yes, ai-input=yes, ai-train=yes
content-usage header: none
tdmrep: 404
ratelimit-policy: "scan";q=20;w=60
ucp: 404
Уподобання щодо використання. Content Signals, які Cloudflare опублікувала у вересні 2025 року, додають у robots.txt рядок Content-Signal із трьома сигналами — search, ai-input і ai-train, кожен зі значенням yes або no (Cloudflare). У нас дозволено всі три. Власний словник IETF з мітками train-ai, ai-use і search поки лишається Internet-Draft (ревізія 08, вересень 2026) і може змінитися (IETF aipref).
Варіант IETF передається рядком Content-Usage у robots.txt або заголовком відповіді Content-Usage, тому блок перевіряє обидва місця. Наш сайт, як видно з виводу, не публікує ні того, ні іншого, а сканер aiSiteReady поки теж не читає Content-Usage. Будь-яке явне машинозчитуване уподобання краще за мовчання.
Підказки про ліміти. Чернетка IETF для заголовків RateLimit-Policy і RateLimit зараз у ревізії 11 (травень 2026) і не є RFC; її приклад — RateLimit-Policy: "default";q=100;w=10, тобто квота 100 за 10 секунд (IETF). Наш заголовок оголошує політику scan: 20 запитів за 60 секунд, це публічний ліміт на запуск скану. Синтаксис, обробку 429 і готові конфігурації для серверів описано в посібнику з RateLimit-Policy.
Комерція залежить від типу сайту. aiSiteReady — SaaS-інструмент, тож 404 на /.well-known/ucp для нас коректний. На нашій головній є Offer із ціною, але немає Product, а поодинокий офер не вважається даними про товар. Для магазину запустіть команду з @type із блоку 4 на сторінці товару й очікуйте Product плюс Offer із price та priceCurrency.
Перевірка сканера щодо фідів товарів також шукає підказки про фіди в заголовках і метаданих. UCP — протокол, який Shopify і Google анонсували в січні 2026 року, — розміщує профіль продавця за адресою /.well-known/ucp (Shopify, UCP). Кроки описано в статті як опублікувати профіль UCP.
Відповідні перевірки сканера: content_usage_policy, rate_limit_hints, product_structured_data, product_feed_hints, agentic_commerce_signals.
Як оцінити аудит і вирішити, що виправляти першим? (хвилини 30–40)
Оцінюйте кожен рядок так само, як сканер: PASS — 1, PARTIAL — 0,5, FAIL — 0, а рядок, що сайту не стосується, випадає. aiSiteReady до того ж зважує перевірки за важливістю (high ×2, medium ×1, low ×0,5) і згортає категорії за профілем в оцінку Agent Readiness Score від 0 до 100 та рівень від 0 до 5 (методологія).
Перевірка, яку не вдалося завершити, отримує статус unknown — «не вдалося перевірити», а не «провалено», тому перевірте її ще раз: доки ви цього не зробили, вона дає 0, як провал, і лишається в загальному рахунку. Профіль Контентний сайт надає категоріям Protocol/API і Комерція нульову вагу, тож ці рядки можна пропустити.
Заповніть робочу таблицю, по рядку на перевірку. Вага — це важливість перевірки в сканері: H, M або L, а прочерк означає, що окремої перевірки в сканері немає. Ваги взято зі сканера; у моїй пріоритизації нижче llms.txt стоїть нижче навмисно.
| Перевірка | Команда | Пройдено, коли | Вага | Виправлення |
|---|---|---|---|---|
| 1 · доступ ботів | цикл curl -A | той самий 200, що в браузера, для кожного user agent ШІ | — | налаштування ботів у файрволі чи CDN |
| 1 · правила для ШІ-ботів | awk, grep '^user-agent' | іменовані групи для пошукових ботів, явне рішення щодо навчання, немає випадкового блокування | H | посібник із robots.txt |
1 · robots.txt | %{http_code}, %{content_type} | 200 text/plain або свідомий 404; ніколи 5xx чи 429 | H | посібник із robots.txt |
| 2 · контент у сирому HTML | лічильник слів perl | сотні слів, один h1 | H | JavaScript-сайти |
| 3 · sitemap | grep -o '<loc>' | XML, ненульова кількість, указаний у robots.txt | H | пошук сторінок |
| 3 · canonical, заголовок Link | grep, hdr | один абсолютний canonical; зв'язки виявлення | L, M | пошук сторінок |
3 · llms.txt | hdr | 200, Markdown, H1, резюме, посилання | H | llms.txt |
| 4 · JSON-LD | grep '@type' | Organization, WebSite; у статей автор і дати | M | структуровані дані |
| 5 · Markdown | заголовок Accept | text/markdown і Vary: Accept | H | Markdown |
| 5 · каталог API | обхід well-known | 200 linkset+json із посиланням на файл OpenAPI | M | каталог API |
| 5 · MCP, skills, A2A | обхід well-known | 200 JSON, якщо ви публікуєте цю поверхню | M | виклик агентами |
| 5 · метадані OAuth | обхід well-known | 200, якщо у вас є OAuth; профіль API/застосунок його очікує | M | OAuth |
| 6 · правила використання | grep content- | явний машинозчитуваний сигнал | M | правила використання |
| 6 · підказки про ліміти | hdr | RateLimit-Policy або Retry-After | L | ліміти |
| 6 · лише магазини | сторінка товару, ucp | Product і Offer із ціною; профіль віддає 200 | M, L | комерція |
Потім відсортуйте провали за впливом (скільки в стеку блокує промах) і зусиллями (скільки часу забере виправлення). Розстановка нижче якісна й розрахована на типовий контентний сайт; в API-продукту протокольні пункти піднімуться вище.
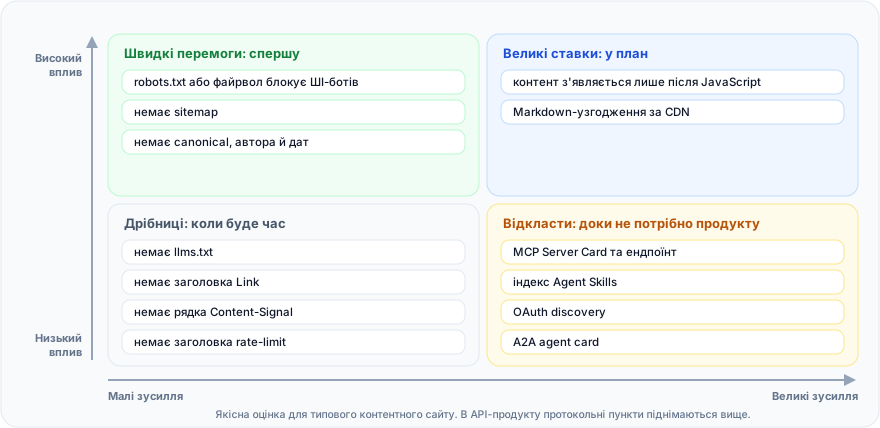
Ідіть по верхньому ряду зліва направо. Правило, що блокує ботів, часто виправляється одним рядком і розблоковує все інше. Сайт із клієнтським рендерингом — це проєкт, але без нього решті стека нічого описувати. Нижній ряд — доопрацювання й задачі, що залежать від продукту. Перезапускайте аудит після кожного виправлення.
Чи можна запустити весь аудит одним скриптом?
Так, для всього, що зводиться до заголовка чи збігу в тілі. Скрипт виконує швидкі перевірки з усіх шести блоків і друкує для кожної PASS, WARN, FAIL або INFO: FAIL — блокувальна проблема, WARN — варто виправити, INFO — необов'язково або залежить від продукту. Пороги за кількістю слів — моє практичне правило, а не пороги сканера.
Спершу скрипт проходить за редиректами від переданого URL, тож голий домен або адреса з http:// перевіряється на тому origin, який відповідає. Ще він дивиться на тип вмісту, а не лише на код статусу: односторінковий застосунок може відповідати 200 з HTML на будь-який шлях.
#!/usr/bin/env bash
# agent-audit.sh - швидка перевірка готовності до ШІ-агентів. Тестуйте лише власні сайти.
# Usage: ./agent-audit.sh https://www.example.com
set -u
SITE="${1:?usage: agent-audit.sh https://www.example.com}"
SITE="${SITE%/}"
# Audit the origin the home page lands on (apex -> www, http -> https).
SITE=$(curl -sS -m 10 -L -o /dev/null -w '%{url_effective}' "$SITE/" 2>/dev/null | sed -E 's#^(https?://[^/]+).*#\1#')
pass=0; warn=0; fail=0
ok()   { printf 'PASS  %s\n' "$1"; pass=$((pass+1)); }
warn() { printf 'WARN  %s\n' "$1"; warn=$((warn+1)); }
bad()  { printf 'FAIL  %s\n' "$1"; fail=$((fail+1)); }
info() { printf 'INFO  %s\n' "$1"; }
code() { curl -sS -L -m 10 -o /dev/null -w '%{http_code}' "$@" 2>/dev/null; }
ctyp() { curl -sS -L -m 10 -o /dev/null -w '%{http_code} %{content_type}' "$@" 2>/dev/null; }
hdrs() { curl -sS -L -m 10 -D - -o /dev/null "$@" 2>/dev/null | tr -d '\r'; }
body() { curl -sS -L -m 10 "$@" 2>/dev/null; }

# 1. REACH
c=$(code "$SITE/")
[ "$c" = 200 ] && ok "home returns 200" || bad "home returned $c"
c=$(ctyp "$SITE/robots.txt")
case "$c" in
  "200 text/plain"*) ok "robots.txt returns 200 text/plain" ;;
  200*) warn "robots.txt returns 200 as ${c#200 } (HTML catch-all?)" ;;
  429*) bad "robots.txt returned 429 (Google treats it like a 5xx)" ;;
  4??*) warn "robots.txt returned ${c%% *} (no rules: crawlers may fetch everything)" ;;
  *)    bad "robots.txt returned ${c%% *} (5xx/unreachable = crawlers assume full disallow)" ;;
esac
for bot in GPTBot OAI-SearchBot ClaudeBot PerplexityBot; do
  c=$(code -A "Mozilla/5.0 (compatible; $bot/1.0)" "$SITE/")
  [ "$c" = 200 ] && ok "UA $bot gets 200" || bad "UA $bot gets $c (user-agent rule? confirm in firewall logs)"
done

# 2. READ
html=$(body "$SITE/")
words=$(printf '%s' "$html" | perl -0777 -pe 's/<(script|style|noscript|template|svg)\b.*?<\/\1>//gsi; s/<[^>]+>/ /gs' | wc -w | tr -d ' ')
if   [ "$words" -ge 200 ]; then ok "$words words in raw HTML"
elif [ "$words" -ge 50 ];  then warn "only $words words in raw HTML"
else bad "$words words in raw HTML (JavaScript shell?)"; fi
printf '%s' "$html" | grep -qi '<h1[ >]' && ok "an h1 is in the raw HTML" || bad "no h1 in the raw HTML"

# 3. DISCOVER
if body "$SITE/robots.txt" | grep -qi '^sitemap:'; then ok "robots.txt lists a Sitemap"; else warn "no Sitemap line in robots.txt"; fi
body "$SITE/sitemap.xml" | grep -qiE '<(urlset|sitemapindex)' && ok "sitemap.xml parses as a sitemap" || warn "no sitemap at /sitemap.xml"
printf '%s' "$html" | grep -qiE '<link[^>]+rel="canonical"' && ok "canonical link found" || warn "no canonical link"
hdrs "$SITE/" | grep -qiE '^link:.*rel="?(sitemap|api-catalog|describedby|alternate)' && ok "Link header advertises discovery relations" || info "no discovery Link header"
case "$(ctyp "$SITE/llms.txt")" in
  "200 text/markdown"*|"200 text/plain"*) ok "llms.txt exists (optional)" ;;
  *) info "no llms.txt (optional)" ;;
esac

# 4. UNDERSTAND
n=$(printf '%s' "$html" | grep -oi 'application/ld+json' | wc -l | tr -d ' ')
[ "$n" -ge 1 ] && ok "$n JSON-LD block(s) in raw HTML" || warn "no JSON-LD in raw HTML"

# 5. CALL
h=$(hdrs -H 'Accept: text/markdown' "$SITE/")
if printf '%s' "$h" | grep -qi '^content-type: text/markdown'; then
  printf '%s' "$h" | grep -qiE '^vary:(.*[ ,])?accept *(,|$)' && ok "Markdown negotiation with Vary: Accept" || warn "Markdown served but no Vary: Accept"
else info "no Markdown negotiation on /"; fi
for p in /.well-known/api-catalog /.well-known/agent-skills/index.json /.well-known/ai-catalog.json /.well-known/mcp/server-card.json /.well-known/agent-card.json; do
  case "$(ctyp "$SITE$p")" in
    200*json*) ok "$p found" ;;
    *) info "$p not found (fine unless you ship it)" ;;
  esac
done

# 6. GOVERN
body "$SITE/robots.txt" | grep -qi '^content-signal:' && ok "Content-Signal in robots.txt" || info "no Content-Signal line"
if body "$SITE/robots.txt" | grep -qi '^content-usage:' || hdrs "$SITE/" | grep -qi '^content-usage:'; then
  ok "Content-Usage (aipref) in robots.txt or a header"
else info "no Content-Usage rule or header"; fi
hdrs "$SITE/" | grep -qiE '^(ratelimit|ratelimit-policy|retry-after):' && ok "rate-limit header on /" || info "no RateLimit-Policy header"

printf '\n%s pass, %s warn, %s fail\n' "$pass" "$warn" "$fail"
[ "$fail" -eq 0 ]
Я запустив його на https://www.ai-siteready.com, на голому https://ai-siteready.com і на http://ai-siteready.com, і всі три прогони збіглися. Кожен надрукував 21 рядок PASS і два рядки INFO (немає AI Catalog і немає Content-Usage) та завершився рядком 21 pass, 0 warn, 0 fail. Це кількість рядків самого скрипта, а не 21 перевірка сканера.
Чистий прогін на нашому сайті сам по собі мало що доводить: я будував сайт під ці перевірки. Показовіший — випадок із помилками. На локальній заглушці, яка віддає лише порожній div і тег script, скрипт закінчується рядком 5 pass, 5 warn, 2 fail і друкує два рядки, що важать найбільше.
FAIL  0 words in raw HTML (JavaScript shell?)
FAIL  no h1 in the raw HTML
За будь-якого FAIL скрипт завершується з ненульовим кодом, тож його можна запускати в CI. Він не оцінить якість контенту, не перевірить JSON-LD за схемою і не відрізнить справжню Markdown-сторінку від підробки. Саме тут потрібен сканер.
Коли автоматизувати аудит готовності до ШІ-агентів?
Переходьте на автоматизацію, коли впираєтеся в будь-яку з цих меж:
- більше за жменьку шаблонів сторінок;
- релізи настільки часті, що регресії ймовірні;
- потрібні докази, які можна передати розробникові;
- хочеться порівнювати скани в часі.
curl перевіряє один URL за раз, а проблема, що б'є найболючіше, зазвичай ховається в шаблоні, який ви пропустили. Браузерні інструменти закривають інший зріз: у Lighthouse, починаючи з Chrome 150, є експериментальна категорія Agentic Browsing — WebMCP, доступність, стабільність верстки й машинозчитуване резюме в корені домену (Chrome).
Саме це автоматизує aiSiteReady. Він завантажує сирий HTML публічного URL без JavaScript, як прості ШІ-краулери, під власним user agent aiAgentReady-Scanner/0.1. Він запускає до 21 перевірки, які покривають ті самі ділянки, що й ваші шість блоків; обраний профіль (Усі перевірки, Контентний сайт, API/застосунок, Інтернет-магазин) визначає, які з них запускаються і що враховується. Скан лише читає й надсилає кожен запит через fetcher із захистом від SSRF.
Він повертає оцінку Agent Readiness Score від 0 до 100 із доказами за кожною перевіркою. Якщо файрвол відповідає сканеру 403 або 429, більшість перевірок отримують unknown, а не fail, бо це вимірює доступ сканера, а не ваш сайт. До кожної проваленої чи часткової перевірки додаються зрозумілі рекомендації та готова задача для розробника. Перевірки, ваги й рівні описано на сторінці методології.
Запустіть безкоштовне сканування, щоб побачити свою оцінку, свій рівень і те, які виправлення робити першими, англійською, українською чи російською.
Спершу доступ і читання, потім виявлення та дані, а агентські ендпоінти й правила — коли їх потребує продукт. Тридцять хвилин із curl знаходять проблеми, що важливі, скрипт не дає їм повернутися, а сканування покриває сторінки, яких ви не перевіряли.
IMozz має 20 років у розробці ПЗ, а останній рік будує продукти за допомогою LLM. Він розвиває aiSiteReady, сканер лише для читання, що перевіряє, чи може ШІ-агент прочитати сайт. Сканер серверно рендерить власний контент як робочий приклад.