Content-Usage (aipref) у robots.txt і HTTP: готові сніпети
Оголосіть уподобання для ШІ через aipref Content-Usage у robots.txt і HTTP-заголовку: train-ai, ai-use, search. Готові сніпети та чесні обмеження, жовт. 2026.
Оголосіть уподобання щодо використання контенту ШІ правилом Content-Usage у robots.txt або HTTP-заголовком Content-Usage, наприклад train-ai=n, search=y. Синтаксис розробляє робоча група IETF AI Preferences (aipref). Така заява виражає намір і нічого не блокує. Обидві специфікації поки що лишаються Internet-Draft, і ніщо не зобов'язує краулер їх читати (драфт словника, драфт прив'язки).
У стеку готовності це один крок після контролю доступу. robots.txt вирішує, хто може завантажити сторінку (як керувати ШІ-краулерами); уподобання щодо використання кажуть, що краулер, який уже її завантажив, може робити далі: навчати модель, брати як вхід для відповіді чи лише індексувати. На відміну від llms.txt, який лише вказує на контент, тут виражено дозвіл. Це один із шарів готовності до ШІ-агентів; аудит за 30 хвилин показує, як він поєднується з рештою. Статус наведено станом на жовтень 2026 року.
Ключові висновки
- Два драфти, RFC поки немає: словник
-08(14 вересня 2026) і правила прив'язки-05(19 серпня 2026). У тексті словника сказано, що драфт загалом, а особливо розділи 3 і 4, не відображає консенсусу робочої групи (IETF datatracker).- Три категорії, два значення:
train-ai,ai-use,search, кожнаyабоn. Не вказано означає «невідомо», а значення за замовчуванням драфт не називає (словник -08).- Один рядок, два місця: рядок
Content-Usageу групіrobots.txtабо заголовок відповіді (прив'язка -05).- Нічого не примушує до виконання. Отримувач сам вирішує, чи дотримуватись заяви, а в документації Google щодо
robots.txtперелічено чотири підтримувані поля, і цього поля серед них немає (Google).Content-Signalвід Cloudflare — інший словник (ai-train=no, а неtrain-ai=n). Наше власне спостереження за кодом: перевіркаcontent_usage_policyв aiSiteReady читає Content-Signal, RSL (Really Simple Licensing), TDMRep (TDM Reservation Protocol) іnoai, алеContent-Usageпоки не читає.
Що таке Content-Usage і що визначають драфти aipref?
Content-Usage — це назва правила в robots.txt та HTTP-заголовка, які несуть коротку заяву про вподобання щодо використання контенту ШІ. Визначають його два Internet-Draft робочої групи IETF з уподобань для ШІ (AI Preferences).
| Драфт | Що визначає | Ревізія | Дата |
|---|---|---|---|
draft-ietf-aipref-vocab | Категорії, модель «дозволити/заборонити», серіалізацію | -08 | 14 верес. 2026 |
draft-ietf-aipref-attach | Правило в robots.txt і HTTP-заголовок | -05 | 19 серп. 2026 |
У словнику три категорії, кожна зі своєю міткою малими літерами (словник -08).
| Мітка | Категорія | Що охоплює, стисло за текстом драфта |
|---|---|---|
train-ai | Навчання ШІ | Використання ресурсу, щоб змінити навчені параметри генеративної моделі |
ai-use | Використання ШІ | Використання ресурсу як вхідних даних генеративної моделі, якщо їх не передав сам користувач |
search | Пошук | Використання ресурсу в застосунку, головна мета якого — підібрати ресурси й спрямувати до них користувачів |
Заява присвоює будь-якій із них y (дозволити) або n (заборонити) і серіалізується як словник Structured Fields: члени через кому, ключі малими літерами, значення — токени y або n без лапок (IETF RFC 9651). Отже, train-ai=n, search=y означає «не навчайтеся на цьому, пошук може використовувати» і нічого не каже про ai-use. Відсутній ключ, значення в лапках "n" або будь-який токен, крім y і n, дають «невідомо», а не помилку.
Категорія search навмисно вузька: вона діє, лише коли результат посилається на оригінал, а фрагменти допомагають користувачеві оцінити релевантність. Переказів і підсумків вона не покриває.
Драфти до того ж змінюються. Після підсумкового обговорення в групі оновлення за жовтень 2025 року описувало категорії Foundation Model Production, AI Output і Search (блог IETF); у нинішньому драфті вони називаються AI Training, AI Use і Search. Термін зі статуту групи на серпень 2026 року для передання обох документів до IESG (органу IETF, що їх затверджує) минув. Datatracker досі показує обидва як документи робочої групи (IETF datatracker), тож сприймайте все сказане тут як знімок станом на жовтень 2026 року.
Як оголосити Content-Usage у robots.txt?
Додайте один або кілька рядків Content-Usage усередині групи User-Agent, за потреби зі шляхом перед уподобанням. Драфт прив'язки називає це двоетапною схемою: Allow і Disallow вирішують, чи може краулер завантажити URL, а Content-Usage каже, що з вмістом можна робити потім (прив'язка -05).
User-Agent: *
Allow: /
Disallow: /admin/
Content-Usage: train-ai=n, search=y
Content-Usage: /blog/ train-ai=y, ai-use=y, search=y
Рядок без шляху діє на все, що групі можна обходити. Рядок, що починається з /, — це префікс шляху, він зіставляється так само, як у Allow і Disallow, і перемагає найдовший збіг; тут /blog/ відкритий для навчання, решта закрита. /admin/ заборонено обходити, а драфт каже, що для ресурсу, який не можна обійти, жодне вподобання не мається на увазі.
Три пастки, перш ніж щось копіювати:
- Іменовані групи нічого не успадковують. Краулер дотримується групи, що збіглася з його токеном продукту, і відкочується до
*, лише якщо жодна не збіглася (IETF RFC 9309). У прикладі самого драфтаExampleBotкористується своєю групою й не застосовує жодного правила з групи*. Якщо ви прописуєте окремі групи для ШІ-краулерів, повторюйте рядок у кожній групі — так само, як посібник про robots.txt радить робити зDisallow. - Краулери кешують
robots.txt. Драфт допускає до 24 годин, а зміни не застосовуються заднім числом до вже завантаженого контенту. - Невідомі рядки ігноруються й можуть викликати попередження. Google пропускає поля, яких немає в його списку (Google), а Cloudflare зазначає, що Search Console може повідомляти
Syntax not understoodдля нових директив, хоча впливу на обхід чи SEO не помічено (документація Cloudflare).
User-Agent: *
Allow: /
Content-Usage: train-ai=n, search=y

User-Agent: GPTBot
Allow: /
Content-Usage: train-ai=n, search=y
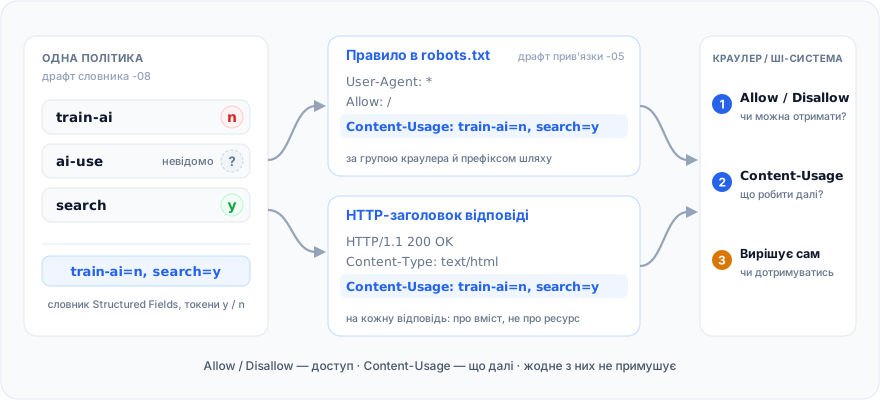
Як надсилати Content-Usage в HTTP-заголовку?
Надсилайте його у відповіді в точно такому самому синтаксисі, як значення в robots.txt. Драфт визначає його як метадані представлення: вони стосуються вмісту повідомлення, а не ресурсу, працюють для будь-якого типу контенту й жодним особливим чином не впливають на кешування. Форми для HTML-тега <meta> та інших способів вбудувати вподобання в сторінку драфт не визначає (прив'язка -05).
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8
Content-Usage: train-ai=n, search=y
В nginx досить одного рядка в блоці server, щоб покрити всі відповіді, зокрема картинки та PDF.
# "always" додає його й до відповідей з помилками (4xx/5xx).
add_header Content-Usage "train-ai=n, search=y" always;
У nginx є правило успадкування, на якому часто спотикаються: add_header передається вниз, лише якщо на поточному рівні немає власних директив, тож location зі своїм add_header мовчки втрачає цей заголовок (документація nginx). Повторіть рядок і там. Якщо заголовки задає сам застосунок, ту саму роботу робить плагін Nitro із тим самим патерном beforeResponse, який aiSiteReady уже використовує для заголовка RateLimit-Policy.
// server/plugins/content-usage.ts
export default defineNitroPlugin((nitroApp) => {
  nitroApp.hooks.hook("beforeResponse", (event) => {
    // У потокової відповіді заголовки вже надіслано.
    if (event.node.res.headersSent) return;
    setResponseHeader(event, "Content-Usage", "train-ai=n, search=y");
  });
});
Заголовок стане в пригоді, коли вподобання різняться за відповідями чи типами файлів або коли ви не можете правити robots.txt, який покриває ваш контент. В інших випадках простіше правило в robots.txt: один файл для аудиту.
Яку політику публікувати? Три приклади
Виберіть одне з трьох значень: train-ai=n, search=y (пошук без навчання), train-ai=y, ai-use=y, search=y (дозволити все) або train-ai=n, ai-use=n, search=n (заборонити все). Скопіюйте відповідний рядок в обидва місця. Усе, що ви пропустите, лишається «невідомим», тож вкажіть категорії, які для вас важливі.
| Політика | Значення Content-Usage | Що оголошує |
|---|---|---|
| Пошук так, навчання ні | train-ai=n, search=y | Без навчання; пошук дозволено; ai-use не вказано |
| Дозволити все | train-ai=y, ai-use=y, search=y | Усі три способи використання вітаються |
| Закрити всі три | train-ai=n, ai-use=n, search=n | Ні навчання, ні ШІ-входу, ні пошуку |
# robots.txt — виберіть один рядок усередині групи User-Agent
Content-Usage: train-ai=n, search=y
# Content-Usage: train-ai=y, ai-use=y, search=y
# Content-Usage: train-ai=n, ai-use=n, search=n
Content-Usage: train-ai=n, search=y
«Закрити всі три» не зупиняє запит, а лише оголошує вашу волю. Щоб не пускати краулер, потрібен Disallow для тих, хто його дотримується, або правило файрвола для решти.
search=y ширше, ніж здається: за драфтом воно охоплює внутрішню обробку пошукового застосунку, навіть навчання моделей, якщо результати посилаються на джерело й показують фрагменти, що допомагають оцінити релевантність. Там-таки сказано, що search перекриває інші категорії там, де вони перетинаються. Це правило з розділу 4, а драфт каже, що текст загалом, а особливо цей розділ, поки не відображає консенсусу робочої групи.
Чим Content-Usage відрізняється від Content-Signal, TDMRep, RSL і noai?
Кожен механізм має власний словник, тому жоден не замінює інший. Найбільше Content-Usage перетинається з Content Signals Policy від Cloudflare, яку публікують рядком Content-Signal у robots.txt зі значеннями yes/no для кожної мети.
| Механізм | Де оголошується | Що виражає | Статус, жовтень 2026 |
|---|---|---|---|
Allow / Disallow | robots.txt | Які шляхи краулер може завантажувати | RFC 9309, Standards Track, 2022 |
| Content-Usage | robots.txt, HTTP-заголовок | train-ai, ai-use, search як y/n | Internet-Draft IETF |
| Content-Signal | robots.txt | ai-train, ai-input, search як yes/no | Текст політики Cloudflare, CC0, анонс 24 вересня 2025 (Cloudflare) |
| TDMRep | HTTP-заголовки, HTML-мета, /.well-known/tdmrep.json | Чи зарезервовано права на text-and-data-mining, плюс URL політики | Final Report із W3C Community Group, 10 травня 2024; не стандарт W3C (W3C) |
| RSL | License: у robots.txt, заголовок Link, HTML | Ліцензія з дозволеними та забороненими способами використання й умовами оплати | RSL 1.0 від 10 грудня 2025, «Recommendation» власного комітету (RSL) |
noai, noimageai | HTML-тег | Відмова від використання в датасетах для навчання ШІ | Неформальна практика DeviantArt, листопад 2022 (TechCrunch) |
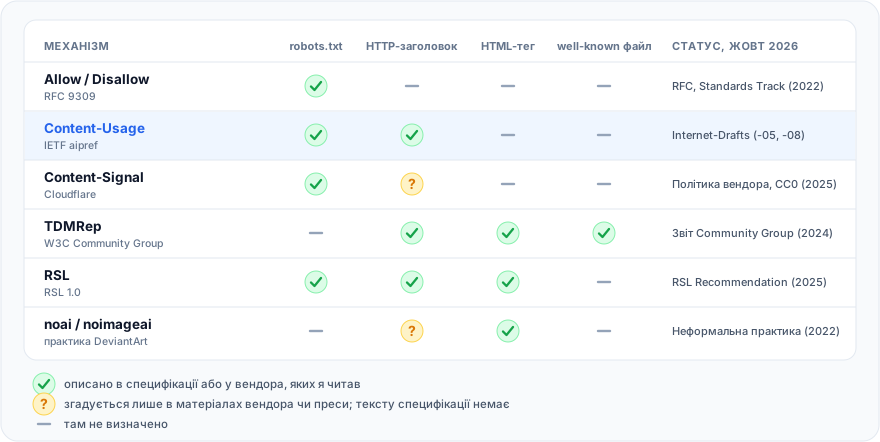
Знак ? у матриці означає, що джерело згадує таке розміщення, але не визначає його: наприклад, changelog Cloudflare говорить про заголовок відповіді content-signal (changelog Cloudflare), а власна перевірка aiSiteReady читає noai в X-Robots-Tag. Content-Signal і Content-Usage — близькі родичі, і мітки в них співвідносяться так.
| Cloudflare Content Signals | IETF Content-Usage | Відмінність |
|---|---|---|
ai-train=yes або no | train-ai=y або n | Різняться і порядок слів у мітці, і токени значень |
ai-input=yes або no | ai-use=y або n | ai-input — це добування й заземлення; ai-use — вхід, якого не передав сам користувач |
search=yes або no | search=y або n | Обидва виключають ШІ-підсумки; драфт IETF додає умову посилання на джерело |
train-ai=no — не валідне вподобання IETF, бо враховуються лише y і n, тож воно мовчки перетворюється на «невідомо». Cloudflare, крім того, тестує необов'язкове четверте поле, use=immediate, reference або full, тож і Content Signals ще розвивається (документація Cloudflare). Якщо публікуєте обидва, хай вони кажуть те саме.
Що відбувається, коли сигнали конфліктують?
Усередині Content-Usage драфти відповідають чітко: перемагає конкретніший шлях, а там, де значення все одно суперечать, діє найсуворіше. Між Content-Usage та всім іншим жоден документ не називає переможця, тож ніколи не публікуйте суперечностей.
- Перемагає довший шлях. У прикладі драфта
train-ai=nбез шляху покриває сайт, а/ai-ok/ train-ai=yперевизначає його для цього піддерева. - Той самий шлях, різні значення: перемагає найсуворіше. Драфт зауважує, що це відрізняється від
AllowіDisallow, де нічия вирішується на користь менш обмежувального варіанта (прив'язка -05, RFC 9309). - Правило в
robots.txtпроти HTTP-заголовка. Драфт прив'язки пріоритету не задає. Діє усталене правило словника «за відсутності іншого способу розв'язати конфлікти»: будь-яка заборона перемагає, потім будь-який дозвіл, інакше невідомо (словник -08). Disallowна шляху. Уподобання стосуються лише ресурсів, які краулер може завантажувати.- Договори сильніші за сигнали. Словник зауважує, що ліцензія, яка прямо дозволяє використання, найімовірніше діє попри машинозчитуване «ні».
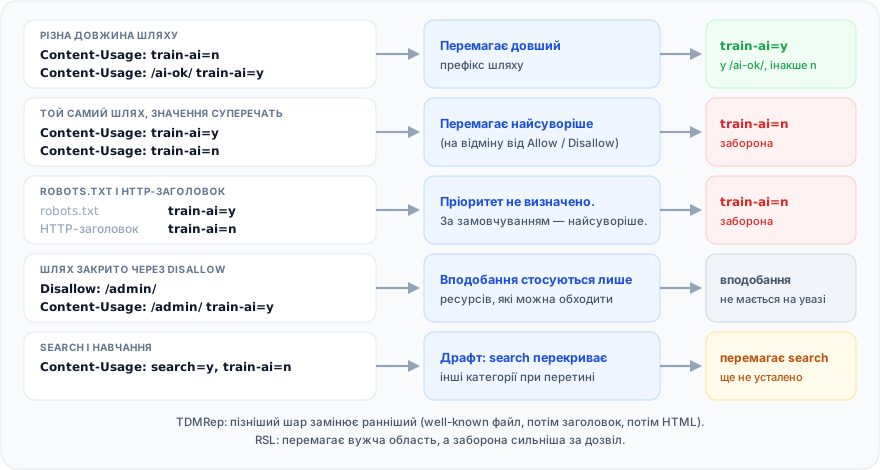
Інші механізми живуть за іншими правилами. TDMRep рекомендує правовласникові застосовувати лише один спосіб, а якщо їх кілька, заголовок замінює well-known файл, а HTML-метадані замінюють і те, й інше (W3C). Правила конфліктів для Content-Signal я в прочитаних матеріалах Cloudflare не знайшов. Тож якщо TDMRep резервує права, а Content-Usage каже train-ai=y, жодна специфікація не визначає, який сигнал перемагає.
Хто насправді дотримується Content-Usage сьогодні?
Я не знайшов першоджерела від великого оператора краулерів, де було б сказано, що він читає Content-Usage, тому вважайте підтримку невідомою й нерівномірною. Що вдалося перевірити:
- Сама специфікація. Вона не гарантує дотримання вподобань, залишає вибір отримувачу й каже, що вподобання — не механізм безпеки (словник -08).
- Google. У документації щодо
robots.txtпереліченоuser-agent,allow,disallowіsitemap, а решту полів названо непідтримуваними (Google). Задокументований механізм контролю ШІ — токенGoogle-Extended(Google). - OpenAI. Сторінка про краулери описує
GPTBotіOAI-SearchBotяк незалежні токениrobots.txt; згадок Content-Signal чи Content-Usage там 2 жовтня 2026 року я не знайшов (OpenAI). - Cloudflare. Content Signals виражають уподобання, а не технічні заходи захисту, і частина компаній може їх ігнорувати (Cloudflare).
Єдина цифра щодо впровадження, яку я можу процитувати: за сканом топ-200 000 доменів Cloudflare Radar, опублікованим у квітні 2026 року, 4% із них оголосили вподобання щодо використання контенту ШІ в robots.txt через Content Signals (Cloudflare). Щодо Content-Usage цифри в мене немає.
Тож будуйте шарами: справжні токени краулерів для доступу, декларація використання, щоб ваш намір було зафіксовано, та правила на сервері чи файрволі для реального блокування. Юридична вага залежить від юрисдикції; текст Content Signals від Cloudflare подає свої обмеження як резервування прав за директивою ЄС 2019/790 про авторське право (Cloudflare), тож обговоріть свій випадок із юристом.
Як перевірити налаштування Content-Usage?
Запитуйте файл і заголовок за публічним URL, а не з localhost: проксі, CDN чи location в nginx можуть змінити те, що бачить краулер.
# 1. Правило в robots.txt (заодно покаже рядок Content-Signal)
curl -sS https://example.com/robots.txt | grep -iE '^content-(usage|signal):'

# 2. Заголовок відповіді на сторінці
curl -sSI https://example.com/ | grep -i '^content-usage:'

# 3. Той самий заголовок на не-HTML файлі з того самого стеку
curl -sSI https://example.com/logo.png | grep -i '^content-usage:'
Очікуйте Content-Usage: train-ai=n, search=y від першої команди та content-usage: train-ai=n, search=y від решти (HTTP/2 приводить імена до нижнього регістру). Порожній вивід означає, що сигналу немає; grep завершиться зі статусом 1. Першу команду я 2 жовтня 2026 року запустив на продакшн-сайті aiSiteReady і отримав один рядок: Content-Signal: search=yes, ai-input=yes, ai-train=yes. Правила чи заголовка Content-Usage там поки немає.
Щоб побачити, до якого висновку дійде споживач, розберіть значення так, як описує драфт, і об'єднайте заяви. Це навмисно спрощене прочитання формату; у продакшені використовуйте повноцінний парсер RFC 9651.
type Pref = "allow" | "disallow" | "unknown";
type Prefs = Record<"train-ai" | "ai-use" | "search", Pref>;
const unknown = (): Prefs => ({ "train-ai": "unknown", "ai-use": "unknown", search: "unknown" });

export function parseUsage(value: string): Prefs {
  const prefs = unknown();
  const seen = new Map<string, string>();
  for (const member of value.split(",")) {
    const [rawKey, rawVal] = member.trim().split("=");
    const key = rawKey.split(";")[0];
    if (/[A-Z]/.test(key)) return unknown(); // ключі чутливі до регістру: розбір падає
    seen.set(key, (rawVal ?? "").split(";")[0].trim()); // повтор ключа: перемагає останній
  }
  for (const key of Object.keys(prefs) as (keyof Prefs)[]) {
    const v = seen.get(key);
    if (v === "y") prefs[key] = "allow";
    else if (v === "n") prefs[key] = "disallow"; // "no", "yes" і "\"n\"" лишаються unknown
  }
  return prefs;
}

// Правило конфліктів за замовчуванням: будь-який disallow перемагає, потім будь-який allow.
export function combine(...all: Prefs[]): Prefs {
  const out = unknown();
  for (const key of Object.keys(out) as (keyof Prefs)[]) {
    const v = all.map((p) => p[key]);
    out[key] = v.includes("disallow") ? "disallow" : v.includes("allow") ? "allow" : "unknown";
  }
  return out;
}

// robots.txt каже "train-ai=y, search=y", заголовок каже "train-ai=n":
console.log(combine(parseUsage("train-ai=y, search=y"), parseUsage("train-ai=n")));
// { 'train-ai': 'disallow', 'ai-use': 'unknown', search: 'allow' }
console.log(parseUsage("train-ai=no, search=y"));
// { 'train-ai': 'unknown', 'ai-use': 'unknown', search: 'allow' }
Я запускав саме цей код, і він друкує показаний вивід. Ось помилки, які я перевіряв би насамперед:
| Помилка | Що відбувається | Виправлення |
|---|---|---|
ai-train=n або train-ai=no | Неправильний порядок слів у мітці чи токен значення: невідомо | Пишіть train-ai=n |
Train-AI=N | Ключі й токени чутливі до регістру: заява не розбирається | Усе малими літерами |
train-ai="n" | Рядок — не токен: невідомо | Пишіть токен n без лапок |
| Шлях без початкового слеша | Усе значення читається як заява й не розбирається: невідомо | Починайте шляхи з / |
Чи може aiSiteReady перевірити ваші сигнали використання?
Частково: його перевірка content_usage_policy знаходить Content-Signal, TDMRep, RSL і noai, але Content-Usage поки не знаходить. На сторінці методології цю перевірку віднесено до категорії Правила для ботів. Подробиці нижче взято з її вихідного коду, який я прочитав, поки писав цю статтю.
Перевірка завантажує сторінку, яку ви скануєте (зазвичай головну), а також /robots.txt і /.well-known/tdmrep.json. У robots.txt вона розпізнає пари Content-Signal і рядки RSL License:. Крім того, вона читає валідні записи TDMRep, метатеги TDMRep і заголовки tdm-reservation та tdm-policy; noai та noimageai у метатегу robots чи в X-Robots-Tag; зв'язки RSL у Link; а також вендорські заголовки й метатеги політик на кшталт ai-policy і content-usage-policy.
Один сильний сигнал дає PASS, лише слабкі чи некоректні дають PARTIAL, а повна відсутність — FAIL. Перевірка оцінює наявність явного оголошення, а не те, в який бік ви його зробили, тож і резервування, і дозвіл проходять.
У її списку заголовків є content-usage-policy, назва в стилі вендорів, але немає content-usage від IETF. Рядок Content-Usage у robots.txt перевірка теж не читає. Інші перевірки robots.txt лише перелічують його як невідому директиву у своїх доказах, і на їхній статус це не впливає.
За моїм прочитанням коду, сайт, що публікує лише aipref, наразі у звіті виглядатиме як сайт без сигналів використання. Тож публікуйте поруч розпізнаваний сигнал на кшталт Content-Signal і стежте, щоб вони не розходилися. Власний robots.txt aiSiteReady публікує дозвільний рядок Content-Signal, і саме він проходить цю перевірку на нашому сайті.
Запустіть безкоштовне сканування, щоб побачити, що з Content-Signal, TDMRep, RSL і noai публікує ваш сайт, які сигнали слабкі й що виправити насамперед, українською, російською чи англійською. Сканер працює лише на читання, ходить через SSRF-безпечний завантажувач і не виконує JavaScript.
Content-Usage дає змогу один раз сказати train-ai=n, search=y і прив'язати це до robots.txt та HTTP-відповідей. Це драфт, якого ніхто не зобов'язаний дотримуватись, тож публікуйте його обережно, тримайте в згоді з наявним Content-Signal і підкріплюйте реальними правилами доступу там, де це важливо.
IMozz має 20 років у розробці ПЗ, а останній рік будує продукти за допомогою LLM. Він розвиває aiSiteReady, сканер лише для читання, що перевіряє, чи може ШІ-агент прочитати сайт. Сканер серверно рендерить власний контент як робочий приклад.