Markdown для ШІ-агентів без Cloudflare: nginx, Nuxt, Next.js
Як віддавати Markdown ШІ-агентам без Cloudflare: map у nginx для Accept: text/markdown, код для Nuxt і Next.js, Vary: Accept та curl-скрипт на 9 перевірок.
Віддавати Markdown ШІ-агентам на власному стеку можна, якщо взяти на себе три завдання, які в Cloudflare виконує керована функція. Це вибір варіанту за Accept: text/markdown, підготовка Markdown і прив'язка кожного кешу до варіанту. Перше й третє в nginx закривають кілька рядків, обробник у Nuxt або Next.js упорається з першим і другим, а матриця curl-перевірок підтвердить усі три.
Це збірка рецептів до статті Markdown для ШІ-агентів: content negotiation, де розібрано причини, патерни віддачі та теорію CDN. Тут ви знайдете робочі конфіги, справжнє Nuxt-middleware aiSiteReady, способи конвертації та регресійний скрипт. Тема належить до шару контенту в стеку готовності до ШІ-агентів, припускає, що факти вже лежать у серверно відрендереному HTML (як зробити JavaScript-сайт читабельним), і закриває те, на що вказує llms.txt.
Ключові висновки
- Керована функція Cloudflare конвертує лише HTML, на відповідних тарифах, і обмежує відповідь origin розміром 2 МБ (документація Cloudflare).
- Власна реалізація — це три завдання: вибір варіанту з урахуванням q, джерело Markdown і ключ кешу, до якого входить варіант.
- nginx може класифікувати
Acceptчерезmap, але не порівнює q-значення, тому рецепт навмисно консервативний (документація nginx).- Власне Nuxt-middleware aiSiteReady вийшло 13 червня 2026 року: справжня логіка q-значень, лише GET (станом на жовтень 2026 року), Markdown будується з тих самих джерел, що й HTML.
- У Next.js 16 угоду про файл
middlewareперейменували наproxy(документація Next.js).
Що робить Markdown for Agents від Cloudflare і що ви замінюєте?
Функція конвертує ваш HTML у Markdown на edge Cloudflare, коли клієнт надсилає Accept: text/markdown, і на origin нічого змінювати не треба. Cloudflare анонсував її 12 лютого 2026 року (блог Cloudflare). На довідковій сторінці перелічено тарифи Pro, Business і Enterprise, а також клієнтів SSL for SaaS, без доплати; вмикається в дашборді або через API. Заявлені обмеження: конвертується лише HTML, а відповідь origin не може перевищувати 2 МБ (2 097 152 байти) (документація Cloudflare).
| Що робить Cloudflare | Що будуєте ви |
|---|---|
Визначає Accept: text/markdown | Перевірку з урахуванням q: у map nginx або в коді застосунку |
| Конвертує HTML на edge | Експорт під час збірки або крок HTML-у-Markdown |
Ставить text/markdown; charset=utf-8 і додає Accept до Vary | Ті самі заголовки на обох варіантах |
Додає x-markdown-tokens і x-original-tokens | Необов'язково й у будь-якому разі приблизно |
Додає Content-Signal: ai-train=yes, search=yes, ai-input=yes, якщо origin його не задав | Свідоме значення або жодного |
Останній рядок важливий: керований варіант за замовчуванням дозволяє навчання й зберігає ваше значення, якщо ви його задали. Якщо віддаєте Markdown самі, ніхто не напише цей рядок за вас, тож обирайте самі (вподобання щодо використання контенту). Поведінку CDN розібрано в попередній статті; тут ідеться лише про кеш, який ви тримаєте самі.
Як віддавати Markdown з nginx?
Згорніть заголовок Accept до одного з двох варіантів через map, а потім за цим варіантом обирайте файл або ключ кешу. map працює в контексті http і перебирає регулярні вирази по черзі, перемагає перший збіг (документація nginx). Порівнювати q-значення він не вміє, тому правило консервативне: Markdown, лише якщо text/markdown указано першим без параметрів, крім q=1. Браузери, */*, відсутній заголовок, text/markdown;q=0 і навіть text/markdown; charset=utf-8 отримують HTML.
map $http_accept $variant {
    default "html";
    # У лапках: у шаблоні є "}" і ";" (правило з документації модуля rewrite nginx).
    "~*^\s*text/markdown\s*(;\s*q=1(\.0{0,3})?\s*)?(,|$)" "md";
}
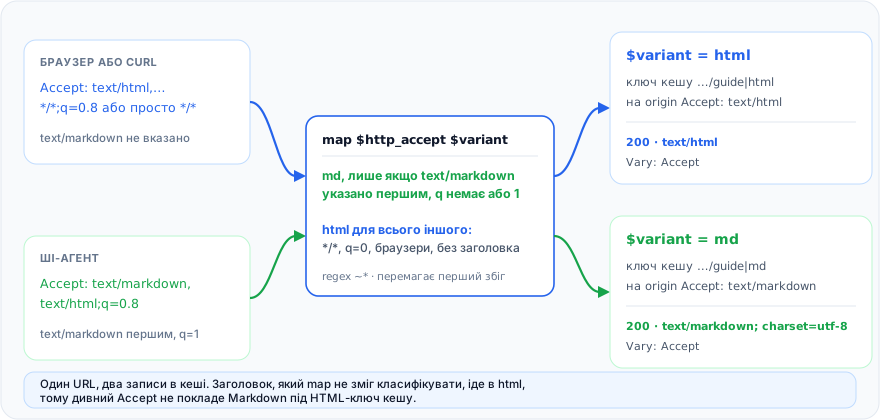
Обидва рецепти я перевірив 3 жовтня 2026 року в офіційному образі nginx:alpine (nginx 1.31): nginx -t не знайшов помилок, а скрипт нижче успішно пройшов на рецепті A.
Рецепт A: Markdown-файли поруч зі сторінками
Якщо збірка кладе index.html та index.md у кожен каталог, nginx віддає потрібний файл. Помістіть це всередину http, поруч із map вище.
gzip on;
gzip_vary on;
gzip_types text/markdown;               # text/html стискається завжди; Markdown треба перелічити

map $variant $index_file {
    md      "index.md";
    default "index.html";
}

server {
    listen 80;
    server_name example.com;
    root /var/www/site;

    # /guide/ перетворюється на /guide/index.md або /guide/index.html. Якщо index.md
    # немає, віддається HTML-сторінка, тож узгоджуваний URL не дає 404. Ресурси
    # проходять тут без змін: без Vary на CSS, JS і зображеннях.
    location / {
        index $index_file index.html;
        try_files $uri $uri/ =404;
    }

    # Markdown-файл: запитано напряму або потрапив сюди через redirect від index.
    location ~ \.md$ {
        types { }                                   # тут mime.types не потрібен
        default_type text/markdown;                 # голий тип, щоб збігся gzip_types
        charset utf-8;
        charset_types text/markdown;                # charset діє лише на ці типи
        add_header Vary Accept always;
    }

    # HTML-сторінки: Vary і посилання на Markdown-двійника.
    location ~ ^(?<dir>/(?:.*/)?)index\.html$ {
        add_header Vary Accept always;
        add_header Link "<${dir}index.md>; rel=\"alternate\"; type=\"text/markdown\"" always;
    }
}
Рецепт тримається на чотирьох деталях:
- Директива
indexприймає змінні й працює через внутрішній redirect, тому запит обробляється заново в томуlocation, що підходить новому URI (документація nginx). Саме тому тип виставляєlocationдля Markdown. - У стандартному
mime.typesнемає запису дляmd(перевірено в репозиторії nginx), тожtypes { },default_type text/markdown,charset utf-8іcharset_types text/markdownзадають тип і charset у вигляді, якийgzip_typesі далі розпізнає. Якщо вписати charset безпосередньо вdefault_type, gzip для Markdown мовчки вимкнеться. add_headerуспадковується лише тоді, коли на поточному рівні немає власних директив, тому заголовки рівня server, наприклад HSTS, доведеться повторити в цих двохlocation(документація nginx).alwaysзберігає заголовки на 404, якщоindex.mdнемає. Якщоindex.mdє не в усіх каталогах, приберіть рядокLinkабо віддавайте його лише там, де файл існує.gzip_vary onдодає другий рядокVaryзAccept-Encoding. Два рядкиVaryприпустимі, боVary— поле-список і одержувач може їх об'єднати (RFC 9110); саме така пара приходить із продакшену aiSiteReady.
Рецепт B: кеш перед застосунком
Коли nginx стоїть перед Nuxt, Next.js або Express, обидва варіанти віддає застосунок, а nginx лише кешує їх окремо. Використовуйте це для сторінок; у JSON API має бути свій Accept.
proxy_cache_path /var/cache/nginx/pages levels=1:2 keys_zone=pages:10m
                 max_size=512m inactive=30m use_temp_path=off;

map $variant $origin_accept {
    md      "text/markdown";
    default "text/html";
}

upstream app {
    server 127.0.0.1:3000;
    keepalive 16;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://app;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Host $host;
        proxy_set_header Accept $origin_accept;     # origin бачить два значення, а не сотні

        proxy_cache pages;
        proxy_cache_key "$scheme://$host$request_uri|$variant";
        proxy_cache_valid 200 5m;
        proxy_cache_valid 404 1m;
        proxy_ignore_headers Vary;                  # ключ за $variant будуємо самі

        add_header X-Cache-Status $upstream_cache_status always;
    }
}
Навіщо ігнорувати Vary? Починаючи з nginx 1.7.7 він кешує відповідь «з урахуванням відповідних полів заголовка запиту» (документація nginx), і кожен окремий рядок Accept від браузерів отримав би свій запис. Ключ за $variant залишає два.
Ціна: якщо origin варіюється ще й за Cookie чи Accept-Language, додайте їх до ключа або не кешуйте ці шляхи. nginx пропускає Vary застосунку як є, тож застосунок має слати Vary: Accept на узгоджуваних сторінках, а не на ресурсах. Ключ за замовчуванням, $scheme$proxy_host$request_uri, узагалі не містить варіанту; рядок proxy_cache_key і є вашим захистом від отруєння кешу з попередньої статті.
Як це робить сервер на Nuxt або Nitro?
Одним серверним middleware, яке відповідає лише на явний запит Markdown, а все інше передає HTML-рендереру. Це справжній код aiSiteReady, доданий 13 червня 2026 року: спершу маркетингові сторінки, того ж вечора статті блогу. Код починається з перевірок.
// frontend/server/middleware/markdown-negotiation.ts (фрагмент, жовтень 2026)
export default defineEventHandler(async (event) => {
  if (!isGetOrHead(event)) { // HEAD узгоджується так само, як GET
    return;
  }
  if (!prefersMarkdown(getRequestHeader(event, "accept"))) {
    return;
  }
  const pathname = getRequestURL(event).pathname;
  // ...визначити сторінку, зібрати Markdown, повернути sendMarkdown(event, markdown)
});
Якщо нічого не повернути, запит іде далі: h3 викликає обробники по черзі, доки один не поверне відповідь (документація h3). Документація Nuxt описує middleware як «лише дивитися» (документація Nuxt), тож повернення значення вважайте поведінкою h3, а не обіцянкою Nuxt, і закріпіть його матрицею нижче. Відповідь збирається в одному місці:
function sendMarkdown(event: H3Event, markdown: string): string {
  setResponseHeader(event, "content-type", "text/markdown; charset=utf-8");
  setResponseHeader(event, "vary", "Accept");
  setResponseHeader(event, "cache-control", "public, s-maxage=300, stale-while-revalidate=86400");
  return bodyForMethod(event, markdown); // HEAD: порожнє тіло, Content-Length як у GET
}
Три рішення варто перейняти:
- HTML тут не конвертується. Маркетингові сторінки збираються з того самого i18n-каталогу й тієї самої структури сторінок, що й Vue-компоненти, а
@nuxt/contentзберігає статтю блогу як розібране дерево, яке невеликий серіалізатор записує назад у Markdown. Обидва представлення будуються з одного джерела, тому вони не розходяться. - Усе, на що middleware не може відповісти, іде далі: невідомий slug отримує чесний 404 від рендерера, а збій запиту до контенту віддає HTML, а не 500.
Varyдля HTML-варіанту береться з route rules, бо SSR формує цю відповідь уже після того, як middleware поступилося дорогою.
// frontend/nuxt.config.ts (фрагмент: правило маршруту, спільне для маркетингових сторінок і статей блогу)
headers: {
  "Cache-Control": "public, s-maxage=300, stale-while-revalidate=86400",
  "Vary": "Cookie, Accept-Language, Accept",
},
Гілка для HEAD теж із перших рук. Перша версія перевіряла лише GET і відправляла запити HEAD у HTML-рендерер: 2 жовтня 2026 року curl -I -H 'Accept: text/markdown' до статті aiSiteReady повернув заголовки text/html, а той самий запит через GET — text/markdown; charset=utf-8. RFC 9110 каже, що на HEAD серверу слід відповідати тими заголовками, що дав би GET (RFC 9110), тому перевірка тепер пропускає HEAD, а bodyForMethod прибирає лише тіло. Якщо копіюєте, виставляйте Content-Length самі: Node не додає його у відповідь на HEAD, якщо обробник не задав його явно.
Як узгоджувати Markdown у Next.js?
Використовуйте файл proxy, щоб переписувати (rewrite) запити Markdown на route handler, і додавайте Vary: Accept до кожної відповіді, яку він обробляє. У Next.js 16.0.0 угоду про файл middleware оголосили застарілою й перейменували на proxy. NextResponse.rewrite віддає інший маршрут під початковим URL, а заголовки відповіді виставляються на поверненому NextResponse (документація Next.js). У Next.js 15 і раніших версіях назвіть файл middleware.ts, а функцію middleware.
// proxy.ts (корінь проєкту, поруч з app/)
import { NextResponse, type NextRequest } from "next/server";
import { prefersMarkdown } from "./lib/prefers-markdown";   // функція з розділу про q-значення
import markdownPaths from "./generated/markdown-paths.json"; // створюється під час збірки

const hasMarkdown = new Set<string>(markdownPaths);          // ["/docs/intro", ...]

export function proxy(request: NextRequest) {
  const { pathname } = request.nextUrl;
  const wants =
    (request.method === "GET" || request.method === "HEAD") &&
    prefersMarkdown(request.headers.get("accept")) &&
    hasMarkdown.has(pathname);

  const response = wants
    ? NextResponse.rewrite(new URL(`/api/md${pathname}`, request.url))
    : NextResponse.next();
  response.headers.append("Vary", "Accept");   // append: Next.js може сам задавати значення Vary
  return response;
}

export const config = {
  matcher: ["/((?!api|_next/static|_next/image|.*\\..*).*)"],
};
Ціль rewrite — Route Handler із попередньої статті. Маніфест часу збірки не дає сторінці без Markdown-двійника перетворитися на 404 для агентів: вона йде в HTML. matcher виключає api, ресурси _next і все, що має розширення файлу.
Застереження: aiSiteReady працює на Nuxt, тож, на відміну від попереднього розділу, цей фрагмент я в продакшені не запускав; він іде за документованим API. Next.js уміє зіставляти й заголовок запиту всередині rewrites(), але регулярний вираз за заголовком не зважить q-значення, а для Vary потрібне окреме правило headers() (документація Next.js). Запустіть матрицю на своїй збірці, перш ніж довіряти будь-якому з варіантів.
Конвертувати під час збірки чи на льоту?
Генеруйте Markdown з того самого джерела, що й HTML, під час збірки, якщо можете; HTML на льоту конвертуйте, лише коли відрендерений HTML — єдине джерело правди. Результат збірки можна перевірити до деплою, він дешево кешується, а все, що згенеровано з джерела, не може розійтися зі сторінкою. aiSiteReady тримається золотої середини: він рендерить Markdown із джерела контенту на кожен запит, без конвертації HTML.
Конвертація на льоту — це конвеєр: отримати HTML, прибрати обв'язку, сконвертувати, виправити посилання, закешувати за URL і варіантом. Середню частину закривають три справжні бібліотеки.
- Turndown конвертує HTML у Markdown у Node та в браузері. За замовчуванням він робить setext-заголовки й блоки коду з відступом, тож задайте
headingStyle: "atx"іcodeBlockStyle: "fenced", а навігацію приберіть черезremove(). - rehype-remark перетворює синтаксичне дерево HTML на дерево Markdown в екосистемі unified:
rehype-parse,rehype-remark, потімremark-stringify. - Mozilla Readability дістає основний контент сторінки, тож навігація, футер і cookie-банер до конвертера не доходять. Їй потрібен DOM, наприклад jsdom.
import TurndownService from "turndown";

const turndown = new TurndownService({ headingStyle: "atx", codeBlockStyle: "fenced" });
turndown.remove(["script", "style", "nav", "footer", "form"]);

export const htmlToMarkdown = (html: string) => turndown.turndown(html);

// Груба оцінка розміру для логів або заголовка з кількістю токенів. Це не токенізатор.
export const estimateTokens = (text: string) => Math.ceil(text.length / 4);
Будь-яке число токенів — наближення. Cloudflare називає свої заголовки оцінкою, а документація Anthropic називає оцінкою власний підрахунок і зауважує, що новий токенізатор дає приблизно на 30 відсотків більше токенів на той самий ввід, ніж попередні моделі (документація Anthropic). Ділення кількості символів на чотири — це орієнтир, а не обіцянка. Конвертація на льоту до того ж успадковує обмеження HTML: якщо факти підвантажуються клієнтським JavaScript, жоден конвертер їх не знайде.
Які помилки з q-значеннями ламають content negotiation?
Майже всі вони походять від того, що Accept сприймають як рядок для пошуку, а не як список діапазонів із вагами. RFC 9110 визначає вагу так: за замовчуванням 1, за 0,001 тип найменш бажаний, а 0 означає «неприйнятно» (RFC 9110).
| Помилка | Приклад Accept | Правильна відповідь |
|---|---|---|
| Пошук підрядка | text/markdown;q=0 | HTML: нуль означає відмову |
| Wildcard сприйнято як згоду | */* (значення curl за замовчуванням) | HTML |
| Рядки браузерів | text/html,…,*/*;q=0.8 | HTML |
| Markdown із меншою вагою | text/markdown;q=0.5, text/html;q=0.9 | HTML |
| Регістр і пробіли | Text/Markdown ; q=1 | Markdown |
| Нічого не підходить | application/json | HTML за політикою або 406 |
| Рівні ваги | text/html, text/markdown | На ваш розсуд; перевірте |
Токен у Vary | Vary: Accept-Encoding | Це не Accept: порівнюйте токени повністю |
Медіатипи нечутливі до регістру, запит без Accept не виражає вподобань, а коли нічого не підходить, сервер може відповісти 406 або проігнорувати заголовок (RFC 9110). Для URL сторінки, яку відкривають і браузери, безпечніше повернути HTML. Нічия теж питання політики, бо RFC не задає правила для рівних ваг: middleware aiSiteReady за будь-якої нічиєї віддає Markdown, а правило nginx іде за порядком у списку, тож text/markdown, text/html отримує Markdown, а text/html, text/markdown — HTML.
Ось правило у вигляді коду: у text/markdown вага має бути більшою за нуль і не меншою за вагу text/html та wildcard. Я порівняв цю стислу версію з тією, що працює в aiSiteReady, на 200 000 випадкових рядків Accept і розбіжностей не знайшов.
export function prefersMarkdown(accept: string | null | undefined): boolean {
  if (!accept) return false;
  const best = new Map<string, number>();            // медіатип -> найбільший указаний q
  for (const part of accept.split(",")) {
    const [type, ...params] = part.split(";").map((s) => s.trim());
    if (!type) continue;
    let q = 1;
    for (const param of params) {
      const [name, value] = param.split("=").map((s) => s.trim());
      const n = Number.parseFloat(value ?? "");
      if (name?.toLowerCase() === "q" && !Number.isNaN(n)) q = Math.min(1, Math.max(0, n));
    }
    const key = type.toLowerCase();
    best.set(key, Math.max(best.get(key) ?? 0, q));
  }
  const md = best.get("text/markdown") ?? 0;
  return md > 0 && md >= (best.get("text/html") ?? 0) && md >= (best.get("*/*") ?? 0);
}
text/* навмисно ігнорується, тож клієнт, що надіслав лише text/*, отримає HTML. Але клієнт, у якого text/* важить більше за text/markdown, однаково отримає Markdown; якщо потрібна строга поведінка за RFC 9110, порівнюйте і з text/*.
Як перевірити узгодження за Accept через curl?
Надішліть один URL із фіксованим набором заголовків Accept і перевірте статус, Content-Type та токени Vary кожної відповіді. Використовуйте GET, а не curl -I, і перевіряйте публічний URL, щоб кеш по дорозі теж брав участь у тесті.
Accept запиту | Очікуваний Content-Type | Статус | Vary |
|---|---|---|---|
text/markdown | text/markdown; charset=utf-8 | 200 | є Accept |
text/markdown, text/html;q=0.8 | text/markdown; charset=utf-8 | 200 | є Accept |
text/markdown,*/*;q=0.1 (сканер aiSiteReady) | text/markdown; charset=utf-8 | 200 | є Accept |
Рядок браузера, */* або без заголовка | text/html | 200 | є Accept |
text/markdown;q=0 | text/html | 200 | є Accept |
text/markdown;q=0.5, text/html;q=0.9 | text/html | 200 | є Accept |
application/json | text/html (політика fallback) | 200 | є Accept |
| Будь-який, на неіснуючому URL | не Markdown | 404 | є Accept (застосунок); статичний сервер може його не ставити |
Скрипт покриває ці рядки дев'ятьма перевірками Accept. Він порівнює Vary за токенами повністю, бо в Accept-Encoding є літери Accept, і попереджає, коли HEAD розходиться з GET. Передавайте кінцевий URL, наприклад /guide/ для рецепта A: скрипт не йде за редиректами, а для неіснуючого URL перевіряє лише статус.
#!/usr/bin/env bash
# використання: ./check-negotiation.sh https://example.com/guide/ [https://example.com/no-such-page]
set -u
URL="${1:?usage: $0 URL [MISSING_URL]}"; MISSING="${2:-}"
BODY="$(mktemp)"; trap 'rm -f "$BODY"' EXIT; fails=0

vary_has_accept() { tr ',' '\n' | sed 's/^ *//; s/ *$//' | grep -qix 'accept'; }

check() {  # мітка | значення Accept ("" — не слати) | очікуваний медіатип
  local label="$1" accept="$2" want="$3" hdrs status ctype problems=""
  local args=(-sS -D - -o "$BODY")
  if [ -n "$accept" ]; then args+=(-H "Accept: $accept"); else args+=(-H 'Accept:'); fi
  hdrs="$(curl "${args[@]}" "$URL" | tr -d '\r')" || { echo "FAIL  $label: request failed"; fails=$((fails+1)); return; }
  status="$(printf '%s\n' "$hdrs" | head -1 | awk '{print $2}')"
  ctype="$(printf '%s\n' "$hdrs" | grep -i '^content-type:' | head -1 | sed 's/^[^:]*: *//' | tr 'A-Z' 'a-z')"
  [ "$status" = 200 ] || problems="$problems status=$status"
  case "$ctype" in "$want"*) ;; *) problems="$problems content-type=[$ctype]" ;; esac
  printf '%s\n' "$hdrs" | grep -i '^vary:' | sed 's/^[^:]*: *//' | vary_has_accept \
    || problems="$problems missing-Vary-Accept"
  if [ "$want" = "text/markdown" ]; then
    case "$ctype" in *charset=utf-8*) ;; *) problems="$problems missing-charset" ;; esac
    head -c 2000 "$BODY" | grep -qiE '<!doctype|<html' && problems="$problems body-is-html"
  fi
  if [ -z "$problems" ]; then echo "ok    $label"; else echo "FAIL  $label:$problems"; fails=$((fails+1)); fi
}

check 'markdown only'        'text/markdown'                         text/markdown
check 'markdown, html q=0.8' 'text/markdown, text/html;q=0.8'        text/markdown
check 'aiSiteReady scanner'  'text/markdown,*/*;q=0.1'               text/markdown
check 'browser'              'text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8' text/html
check 'curl default */*'     '*/*'                                   text/html
check 'no Accept header'     ''                                      text/html
check 'markdown refused'     'text/markdown;q=0'                     text/html
check 'html preferred'       'text/markdown;q=0.5, text/html;q=0.9'  text/html
check 'json only'            'application/json'                      text/html

head_type="$(curl -sS -I -H 'Accept: text/markdown' "$URL" | tr -d '\r' | grep -i '^content-type:' | head -1 | sed 's/^[^:]*: *//')"
case "$head_type" in text/markdown*) echo "ok    HEAD mirrors GET" ;; *) echo "WARN  HEAD returned [$head_type]" ;; esac

if [ -n "$MISSING" ]; then
  code="$(curl -sS -o /dev/null -w '%{http_code}' -H 'Accept: text/markdown' "$MISSING")"
  case "$code" in 404|410) echo "ok    missing page -> $code" ;; *) echo "FAIL  missing page -> $code"; fails=$((fails+1)) ;; esac
fi
[ "$fails" -eq 0 ] && echo PASS || { echo "$fails check(s) failed"; exit 1; }
Я перевірив його на локальному сервері в трьох зламаних режимах. Перевірка підрядка за Accept завалює перевірки q=0 і «html preferred»; сервер, що віддає лише Vary: Accept-Encoding, завалює всі перевірки; обробник лише для GET проходить із попередженням про HEAD. На статті aiSiteReady 2 жовтня 2026 року пройшли всі дев'ять перевірок Accept, неіснуюча стаття повернула 404, а рядок про HEAD видав попередження. Після виправлення HEAD цей рядок має вигляд ok HEAD mirrors GET.
Який підхід обрати?
Якщо ви вже проксіюєте через Cloudflare і ваш HTML підходить, увімкніть керовану функцію; на власному сервері експортуйте Markdown під час збірки, узгоджуйте варіант у nginx і публікуйте .md-сусідів на додачу. В іншому обирайте за тим, кому належить сервер і звідки береться Markdown.
| Варіант | Обирайте, коли | Що лишається вам |
|---|---|---|
| Керована конвертація (Cloudflare) | Ви вже проксіюєте через нього на відповідному тарифі | Рішення щодо Content-Signal |
Експорт під час збірки плюс map у nginx | Статичний або Markdown-first сайт на вашому сервері | Крок збірки, ключ кешу |
| Рендер із джерела на кожен запит (aiSiteReady) | Джерело лежить у CMS або @nuxt/content | Серіалізатор, Vary, ключ кешу |
| На льоту в застосунку | Відрендерений HTML — єдине джерело | Конвертер, тести, CPU |
Лише .md-сусіди | Статичний хостинг, невідомий CDN | Дублі URL |
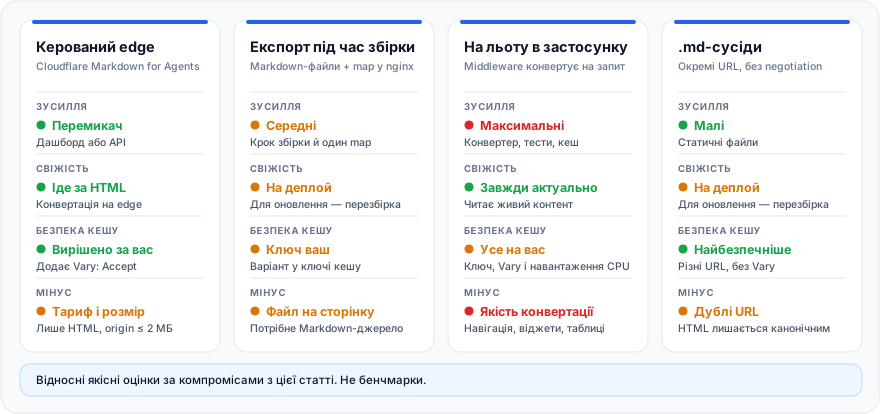
Для контентного сайту на власному сервері ця зв'язка з Markdown під час збірки, узгодження в nginx і .md-сусідів — мій вибір за замовчуванням. Сусіди потрібні, щоб клієнт, який ніколи не шле Accept: text/markdown, усе одно міг забрати файл. Пропозиція llms.txt допускає page.md або page.html.md, а для URL-каталогів index.md або index.html.md (llmstxt.org). Запасна проба aiSiteReady робить один запит: page.md для URL сторінки, index.html.md для URL каталогу.
Як перевірка Markdown в aiSiteReady оцінює сторінку?
Перевірка markdown_negotiation в aiSiteReady запитує сторінку так, як це зробив би агент, і оцінює відповідь як PASS, PARTIAL, FAIL або UNKNOWN, з доказами. Вона має високу серйозність і вагу 2,0 всередині категорії Доступність контенту, яка дає 25% оцінки (40% у профілі Контентний сайт). Канонічний URL запитують із Accept: text/markdown,*/*;q=0.1 через SSRF-безпечний fetcher, JavaScript не виконується. Лише якщо цей запит не пройшов, перевірка запитує .md-URL у стилі llms.txt.
- PASS:
Content-Typeрівноtext/markdown, тіло схоже на Markdown, і єVary: Acceptабо оголошенийLink: rel="alternate"; type="text/markdown". Сусідній URL із Markdown проходить і безVary. - PARTIAL: застарілий тип
text/x-markdown, Markdown безVaryіLink,Link: rel="alternate"; type="text/markdown"на відповіді, яка не є Markdown (ціль посилання сканер не запитує), або HTML ізVary: Accept. Будь-яка інша ознака Markdown, наприклад схоже на Markdown тіло з іншим типом, теж дає PARTIAL. - FAIL: у жодній із відповідей немає ознак Markdown або відповідь не 2xx. Виняток: 403 і 429 дають UNKNOWN, бо блокування бота — не вердикт; так само трактуються таймаути й тіла понад 2 МБ.
«Схоже на Markdown» означає щонайменше два сигнали (заголовок, посилання, список, блок коду, відсутність HTML-тегів) і не більше трьох HTML-тегів (до чверті рядків, якщо відповідь віддано як text/markdown).
Ця евристика зіграла проти нас: коли блог почав віддавати text/markdown, одна технічна стаття оцінилася як не-Markdown через 32 тегоподібні рядки, і всі вони були в прикладах коду. Виправлення сканера того ж вечора, 13 червня 2026 року, навчило його ігнорувати теги всередині fenced- та inline-коду; теги в прозі, як і раніше, враховуються.
Точні ваги описано на сторінці методології; перевірка Markdown стоїть поруч із llms.txt у шарі доступності контенту зі статті що означає готовність до ШІ-агентів. Запустіть безкоштовне сканування, щоб побачити, чи віддає ваш сервер справжній Markdown на Accept: text/markdown, якого заголовка бракує й що виправити першим, — англійською, українською чи російською.
Якщо коротко: Markdown для агентів на власному сервері — це три завдання, а не платформа. Оберіть варіант за Accept з урахуванням q, підготуйте Markdown з джерела, яке вже маєте, і зробіть так, щоб кожен кеш між вами та агентом знав: в одного URL два представлення.
IMozz має 20 років у розробці ПЗ, а останній рік будує продукти за допомогою LLM. Він розвиває aiSiteReady, сканер лише для читання, що перевіряє, чи може ШІ-агент прочитати сайт. Сканер серверно рендерить власний контент як робочий приклад.