Agent Skills и SKILL.md: пишем, индексируем, проверяем
Напишите SKILL.md для Agent Skills на своём сайте, добавьте его в /.well-known/agent-skills/index.json и проверьте sha256-digest одним скриптом на curl.
Agent Skill для сайта — это файл SKILL.md, который объясняет агенту, как пользоваться вашим сайтом или API, плюс запись в /.well-known/agent-skills/index.json, по которой агент находит файл и проверяет, что он не изменился. Формат файла взят с agentskills.io. Индекс обнаружения — отдельный черновик с пятью обязательными полями на навык, и проще всего незаметно ошибиться в поле digest: SHA-256 от точных байтов, которые вы отдаёте.
Навыки — последний слой стека готовности. Сначала агент добирается до ваших страниц и читает их, потом находит, что можно вызвать, потом узнаёт, как этим правильно пользоваться. Как сделать сайт доступным для вызова агентами рисует всю карту: MCP Server Card говорит, куда подключаться, каталог API перечисляет ваши API.
Эта статья — подробный разбор именно этого слоя. Сразу оговорка: формат SKILL.md поддерживают широко, а индекс для сайтов появился позже, поддержан слабее и всё ещё остаётся черновиком. Подтвердить я смог одного открытого клиента, который его читает.
Ключевые выводы
- Навык — это
SKILL.mdс YAML front-matter:name(до 64 символов, строчные буквы, цифры, дефисы) иdescription(до 1 024 символов), где сказано, что навык делает и когда его применять (спецификация Agent Skills).- Обнаружение на сайтах — черновик, а не RFC IETF: Agent Skills Discovery 0.2.0, обновлён 12 марта 2026 года. Индекс перечисляет навыки с полями
name,type,description,urlиdigest(cloudflare/agent-skills-discovery-rfc).digest— этоsha256:и хеш сырых байтов артефакта. Клиент ОБЯЗАН (MUST) его проверить и НЕ ВПРАВЕ использовать файл при несовпадении (тот же черновик).- Самый дешёвый способ избежать дрейфа — считать digest от тех же байтов, которые отдаёт маршрут. Так делает aiSiteReady, и я проверил результат снаружи через
shasum.- Проверка
agent_skillsв aiSiteReady валидирует форму индекса и формат digest.SKILL.mdона не скачивает, поэтому скрипт проверки ниже запускайте сами.
Что такое Agent Skill и чем он отличается от документации API?
Agent Skill — это папка с обязательным файлом SKILL.md (YAML front-matter плюс инструкции в Markdown) и необязательными каталогами scripts/, references/ и assets/ (спецификация Agent Skills). В отличие от документации API, которая говорит, что существует и где, навык говорит агенту, что делать. Формат изначально разработала Anthropic и выпустила как открытый стандарт; в списке клиентов на agentskills.io сейчас больше сорока поддерживающих его продуктов.
Масштабируется он за счёт постепенной загрузки. При старте агент читает только name и description каждого навыка — около 100 токенов на навык. Когда задача подходит, он загружает тело SKILL.md — до 5 000 токенов. Приложенные файлы грузятся, только если на них ссылаются инструкции (документация Anthropic).
Этим навык и отличается от документации API. OpenAPI и Server Card говорят агенту, что существует и где. Навык говорит, что делать: когда он применим, какие вызовы и в каком порядке делать и как поступать при сбое. Своего транспорта и эндпоинта он не объявляет.
| Поле front-matter | Правило |
|---|---|
name (обязательно) | До 64 символов; строчные буквы, цифры, дефисы; без дефиса в начале, в конце и без двойного; должно совпадать с именем родительской папки |
description (обязательно) | От 1 до 1 024 символов; говорит, что делает навык и когда его применять |
Необязательные поля — license, compatibility, metadata и экспериментальное allowed-tools. Платформа Anthropic добавляет два правила: в обязательных полях не должно быть XML-тегов, а в имени — слов anthropic и claude. Поскольку имя должно совпадать с папкой, навык сайта scan-url естественным образом лежит по адресу /.well-known/agent-skills/scan-url/SKILL.md.
Как агенты находят навыки на сайте?
Они запрашивают один JSON-файл по well-known-пути. Механизм описан в черновике Agent Skills Discovery в GitHub-репозитории Cloudflare: издатель ОБЯЗАН (MUST) отдавать /.well-known/agent-skills/index.json со списком всех навыков (cloudflare/agent-skills-discovery-rfc). На 2 октября 2026 года это версия 0.2.0, опубликованная 17 января 2026 и обновлённая 12 марта 2026. Она опирается на RFC 8615, но не является документом IETF, а записи agent-skills в реестре well-known URI от IANA, обновлённом 16 сентября 2026 года, я не нашёл. Детали могут измениться.
Вот реальный индекс aiSiteReady, снятый с продакшена 2 октября 2026 года.
{
  "$schema": "https://schemas.agentskills.io/discovery/0.2.0/schema.json",
  "skills": [
    {
      "name": "scan-url",
      "type": "skill-md",
      "description": "Submit a public URL and receive an Agent Readiness Score (0–100) with per-check evidence and prioritized, localized remediation guidance for AI-agent and AI-search readiness.",
      "url": "https://www.ai-siteready.com/.well-known/agent-skills/scan-url/SKILL.md",
      "digest": "sha256:1d7a33bcc768060bbba4328bec09637e6dcc043ada3c85f19f758879bde54ffb"
    }
  ]
}
$schema — непрозрачный идентификатор версии. Клиент должен предупредить о незнакомом значении и пропустить индекс, а при отсутствии $schema считать индекс старым форматом 0.1.0. Каждая запись в skills обязана содержать все пять полей.
| Поле записи | Правило из черновика |
|---|---|
name | Те же правила, что и для имени в SKILL.md |
type | skill-md для одного файла или archive для .tar.gz или .zip с SKILL.md в корне; неизвестные типы клиент пропускает |
description | До 1 024 символов; СЛЕДУЕТ (SHOULD) совпадать с описанием из front-matter |
url | Полный URL, путь от корня сайта или путь, относительный к URL индекса |
digest | sha256: и 64 строчных hex-символа от сырых байтов артефакта |
Строку $schema сравнивают, а не скачивают. Черновик говорит, что она не обязана открываться, и у хоста schemas.agentskills.io при моей проверке 2 октября 2026 года не было DNS-записи.
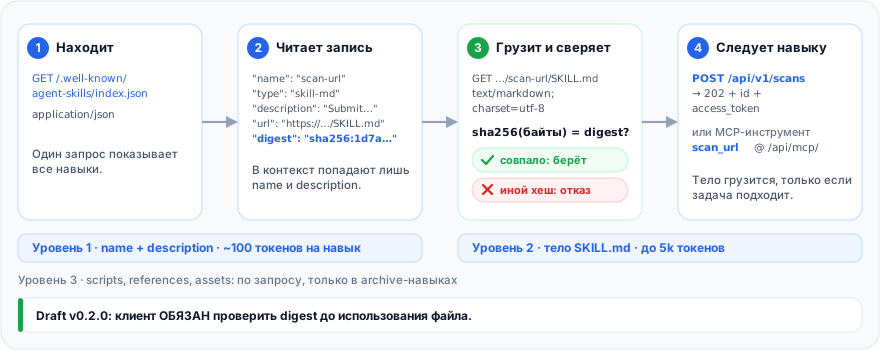
Кто на самом деле читает индекс? Поддержка неравномерна. Открытый установщик skills от Vercel Labs реализует версию 0.2.0: npx skills add https://your-domain читает индекс, скачивает все перечисленные навыки, сверяет хеш каждого с digest и только потом даёт выбрать, что установить (исходник, разбор Evil Martians, август 2026). В остальных местах поддержка слабее: майский запрос 2026 года на загрузку навыков из well-known-URL в Claude Code закрыли через месяц как неактивный, так и не реализовав.
Как написать SKILL.md, которым агенты действительно пользуются?
Начните с description: это всё, что агент видит, прежде чем решить. Руководство Anthropic советует писать, что навык делает и когда его применять, от третьего лица и с конкретными ключевыми словами, и предостерегает от расплывчатых вроде «Helps with documents» (Skill authoring best practices).
Для сайта назовите ситуацию пользователя: «Looks up the status of an order by order number. Use when a user asks where an order is, whether it shipped, or when it will arrive».
Дальше в теле нужны пять разделов в таком порядке.
| Раздел | Что в нём | Зачем |
|---|---|---|
| When to use | Ситуации словами пользователя | Подтверждает совпадение |
| How to invoke | Точные эндпоинты, методы, параметры, пример запроса | Агент не угадает ваш API |
| Output | Форма результата | Не даёт выдумывать поля |
| Errors and limits | Каждая ошибка, следующий шаг, лимиты | Не даёт уйти в цикл повторов |
| Scope and safety | Чего навык не делает; никаких секретов | Текст попадает прямо в контекст агента |
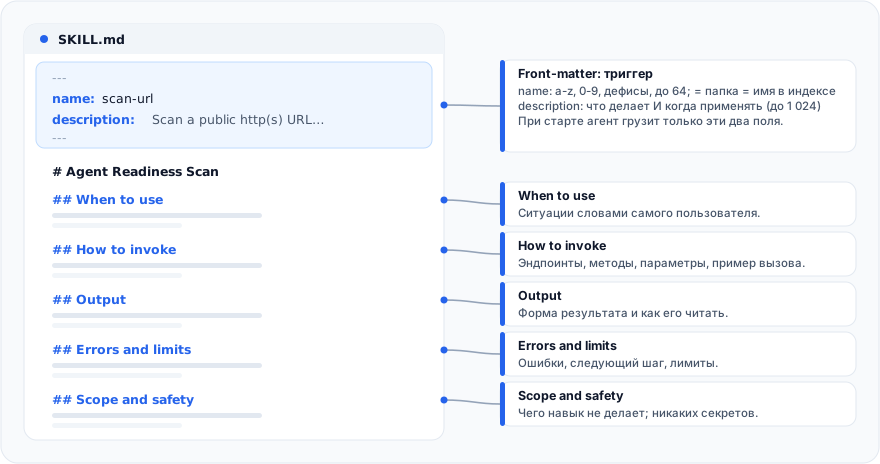
Последняя строка важнее, чем кажется. SKILL.md попадает прямо в контекст агента, поэтому черновик предупреждает, что вредоносный файл может внедрить инструкции, а клиентам рекомендует грузить навыки только из доверенных (allowlist) источников (черновик, раздел Security considerations).
Пишите только о действиях вашего сайта, никогда не просите агента куда-либо отправлять данные пользователя и прямо говорите, что выходит за рамки навыка. Там же сказано, что клиентам НЕЛЬЗЯ (SHALL NOT) по умолчанию исполнять файлы из scripts/, так что навык для сайта не должен от скриптов зависеть. Берите один файл skill-md короче 500 строк (agentskills.io).
Вот front-matter и первый раздел собственного навыка scan-url из aiSiteReady — в том виде, как он отдаётся, без вводного абзаца.
---
name: scan-url
description: Scan a public http(s) URL for AI-agent and AI-search readiness and return an Agent Readiness Score (0-100) with per-check evidence and prioritized, localized remediation guidance across discoverability, content accessibility, bot governance, protocol/API discovery, and commerce.
license: Apache-2.0
---

# Agent Readiness Scan

## When to use

- A user asks whether a site is discoverable, parseable, or usable by AI agents and
  AI-search crawlers.
- You need a structured readiness report (robots/sitemap/llms.txt, structured data,
  bot governance, MCP/A2A/API discovery, commerce signals) for a URL.
Сверив его со своим же чек-листом, я нашёл три пробела:
- В описании сказано, что навык делает, но нет оборота «используйте, когда»: эта фраза лежит в теле, которое агент читает уже после решения.
- REST-вариант предлагает «poll the returned report path», но ответ
202наPOST /api/v1/scansсодержитidиaccess_token, а не путь, и непубличный отчёт без токена не прочитать. - Раздела с ошибками нет.
Вот что я бы добавил, взяв коды статусов из живого документа OpenAPI.
### Option B - REST API

1. `POST /api/v1/scans` with {"url": "https://example.com", "profile": "all", "locale": "en"}.
   The `202` response carries `id` and `access_token`.
2. Poll `GET /api/v1/scans/{id}` with the header `X-Scan-Access-Token: <access_token>`
   until `status` is `succeeded` or `failed`.
3. Read `GET /api/v1/scans/{id}/report.json` with the same header.

## Errors and limits

- `400` `invalid_scan_url`: the URL is not a public http(s) address. Ask for another one.
- `409` `idempotency_conflict`: the same `Idempotency-Key` was sent with a different body.
- `422` `validation_error` or `invalid_check_selection`: the request body is invalid. Fix it; do not resend it unchanged.
- `429` `rate_limited`: wait the number of seconds in `Retry-After`, then retry once.
- `503` `queue_unavailable`: try again later; do not loop.
- Only public pages are scanned: no logins, no remote JavaScript.
Если лимиты описаны в навыке, публикуйте их и заголовками: см. заголовки RateLimit-Policy для ИИ-агентов.
Как отдавать индекс и SKILL.md?
Как статические, публичные, кэшируемые файлы с честными медиатипами. Черновик конкретен в том, что сервер ОБЯЗАН (MUST) и что СЛЕДУЕТ (SHOULD) делать (черновик, раздел HTTP Considerations); в последнем столбце — то, что продакшен-маршруты aiSiteReady вернули 2 октября 2026 года.
| Ресурс | Требование | aiSiteReady |
|---|---|---|
| Медиатип индекса | MUST быть application/json | application/json; charset=utf-8 |
Медиатип SKILL.md | MUST быть text/markdown или text/plain | text/markdown; charset=utf-8 |
| Методы | MUST поддерживать GET и HEAD | Только GET на 2 октября 2026 года; оба — после исправления (см. ниже) |
| Отсутствующий навык | MUST вернуть 404 | 404 с JSON-телом |
| Кэширование | SHOULD задать Cache-Control | public, max-age=3600 |
| CORS | SHOULD задать заголовки для браузерных потребителей | Не задан |
HTTP/2 200
content-type: application/json; charset=utf-8
cache-control: public, max-age=3600

HTTP/2 200
content-type: text/markdown; charset=utf-8
cache-control: public, max-age=3600
vary: Accept-Encoding
Поле url может быть полным URL, путём от корня сайта (разрешается относительно origin индекса) или путём, относительным к каталогу индекса. aiSiteReady публикует полные URL, и у этого есть цена.
Генератор индекса берёт origin из NUXT_PUBLIC_SITE_URL, а если переменная не задана, откатывается к dev-origin localhost:5173. Сканер отклоняет такой URL — в localhost нет точки, а 5173 не порт 80 или 443, — поэтому продакшен-деплой, где про переменную забыли, публикует индекс, который проверка оценивает как PARTIAL. Пути от корня обошли бы проблему, и установщик, чей код я читал, разрешает их через new URL(entry.url, indexUrl), но проверяйте каждого клиента, который вам важен.
Для статического сайта фреймворк не нужен. Этот скрипт копирует каждый навык побайтово в публичную папку и пишет индекс по тем же байтам.
// node build-skills-index.mjs https://example.com
// Читает skills/<name>/SKILL.md, копирует каждый файл побайтово в public/
// и пишет индекс, digest которого считается по этим же байтам.
import { createHash } from "node:crypto";
import { mkdirSync, readFileSync, readdirSync, writeFileSync } from "node:fs";
import { join } from "node:path";

const origin = (process.argv[2] ?? "").replace(/\/$/, "");
if (!origin.startsWith("https://")) throw new Error("usage: node build-skills-index.mjs https://example.com");

const out = "public/.well-known/agent-skills";
const skills = [];
const names = readdirSync("skills", { withFileTypes: true })
  .filter((d) => d.isDirectory()) // пропускаем случайные файлы вроде .DS_Store
  .map((d) => d.name)
  .sort();
for (const name of names) {
  const bytes = readFileSync(join("skills", name, "SKILL.md")); // сырые байты, без перекодирования
  const front = /^\uFEFF?---\r?\n([\s\S]*?)\r?\n---/.exec(bytes.toString("utf8"))?.[1] ?? "";
  const field = (key) =>
    new RegExp(`^${key}:\\s*(.+)$`, "m").exec(front)?.[1].trim().replace(/^(["'])(.*)\1$/, "$2");
  if (field("name") !== name) throw new Error(`${name}: front-matter name must equal the folder name`);
  const description = field("description");
  if (!description || /^[>|]/.test(description)) throw new Error(`${name}: front-matter needs a one-line description`);

  mkdirSync(join(out, name), { recursive: true });
  writeFileSync(join(out, name, "SKILL.md"), bytes); // отдаём ровно то, что хешировали
  skills.push({
    name,
    type: "skill-md",
    description, // тот же текст, что в front-matter: черновик говорит, что он SHOULD совпадать
    url: `${origin}/.well-known/agent-skills/${name}/SKILL.md`,
    digest: `sha256:${createHash("sha256").update(bytes).digest("hex")}`,
  });
}

const schema = "https://schemas.agentskills.io/discovery/0.2.0/schema.json";
writeFileSync(join(out, "index.json"), `${JSON.stringify({ $schema: schema, skills }, null, 2)}\n`);
console.log(`wrote ${skills.length} skill(s) to ${out}`);
Проверьте content-type, который ваш хостинг отдаёт для .md-файлов. В стандартном nginx нет MIME-типа для md, и он отдаёт application/octet-stream, нарушая MUST из черновика; добавьте types { text/markdown md; } в блок http (в блоке server директива заменяет всю таблицу типов, включая JSON). И убедитесь, что отсутствующий навык даёт 404: одностраничное приложение, которое на любой неизвестный путь отвечает своей HTML-оболочкой с кодом 200, с радостью «отдаст» несуществующий SKILL.md.
Как не допустить расхождения digest с отдаваемым файлом?
Считайте его от тех же байтов, которые отдаёте, и на том же шаге. Digest — это sha256: и хеш сырых байтов артефакта, а клиент ОБЯЗАН (MUST) проверить его после загрузки и НЕ ВПРАВЕ использовать файл при несовпадении (черновик, раздел Integrity). Установщик Vercel Labs делает ровно это: fetchArtifactSkillByEntry хеширует скачанные байты и возвращает null, если результат отличается от entry.digest, а fetchAllSkills отфильтровывает такие null. Навык молча исчезает из списка, а ошибки о digest вы не увидите.
Так что дрейф — тихая поломка: правите SKILL.md, забываете пересобрать индекс — и клиенты, соблюдающие спецификацию, перестают использовать навык, а вы не увидите ни одной ошибки. Хешируйте распакованное тело, а не gzip-передачу. Всё, что переписывает байты уже после хеширования, например конвертация переводов строк или прокси, вставляющий футер, тоже ломает совпадение.
aiSiteReady устраняет проблему структурно. Текст навыка живёт в одной TypeScript-константе. Маршрут возвращает эту константу, а digest считается от неё при загрузке модуля. Второй копии, которую можно отредактировать отдельно, просто нет.
// константа навыка и её digest (сокращено)
import { createHash } from "node:crypto";

export const SCAN_URL_SKILL_MD = `---
name: scan-url
description: Scan a public http(s) URL …
---
…`;

export const SCAN_URL_SKILL_DIGEST = `sha256:${createHash("sha256")
  .update(SCAN_URL_SKILL_MD, "utf8")
  .digest("hex")}`;
// обработчик маршрута SKILL.md (сокращено)
export default defineReadOnlyHandler((event) => { // одинаково для GET и HEAD; 405 на прочие методы
  setResponseHeader(event, "Content-Type", "text/markdown; charset=utf-8");
  return SCAN_URL_SKILL_MD; // ровно та константа, от которой посчитан digest
});
Я проверил это снаружи 2 октября 2026 года. Продакшен-файл весит 2 476 байт, а shasum -a 256 печатает 1d7a33bc…bde54ffb — digest из индекса. Тело навыка при этом относительное к origin: в нём пути вроде /api/mcp/, а не абсолютные URL, поэтому байты, а с ними и digest, одинаковы на любом домене деплоя.
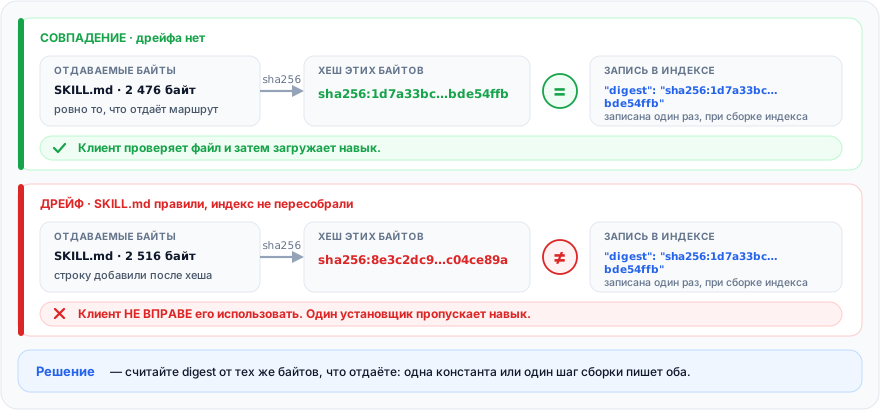
Если хостить навыки там, где вы ничего не контролируете, например по сырым ссылкам GitHub, эта гарантия теряется: правки в апстриме меняют байты под уже опубликованным digest. Правило Evil Martians — писать где угодно, а публиковать из места, которое вы контролируете (Evil Martians).
Как проверить индекс Agent Skills?
Проверяйте три вещи: индекс парсится и имеет верную форму, каждый url отдаёт правильный медиатип, а каждый digest совпадает с байтами. Ручной вариант — три команды curl.
# 1. заголовки и тело индекса
curl -sSi https://example.com/.well-known/agent-skills/index.json | head -20
# 2. все навыки и заявленные digest
curl -sS https://example.com/.well-known/agent-skills/index.json | jq -r '.skills[] | [.name, .digest] | @tsv'
# 3. реальный хеш отдаваемого навыка, чтобы сравнить на глаз
curl -sS https://example.com/.well-known/agent-skills/scan-url/SKILL.md | shasum -a 256
Для CI всё это делает один скрипт. Ему нужны curl, jq и shasum (на Linux без него подставьте sha256sum), и при любой ошибке он завершается с ненулевым кодом.
#!/usr/bin/env bash
# usage: ./check-skills.sh https://example.com
set -euo pipefail
ORIGIN="${1:?usage: check-skills.sh https://example.com}"
ORIGIN="${ORIGIN%/}"
INDEX="$ORIGIN/.well-known/agent-skills/index.json"
SCHEMA="https://schemas.agentskills.io/discovery/0.2.0/schema.json"
bad=0
ok()   { printf 'ok    %s\n' "$*"; }
fail() { printf 'FAIL  %s\n' "$*"; bad=1; }
tmp="$(mktemp)"; trap 'rm -f "$tmp"' EXIT

# 1. Индекс: статус, медиатип, поддержка HEAD, $schema
meta="$(curl -sS -o "$tmp" -w '%{http_code} %{content_type}' "$INDEX")"
[[ "$meta" == 200\ application/json* ]] && ok "index: GET 200, ${meta#* }" || fail "index: GET -> $meta"
[[ "$(curl -sS -I -o /dev/null -w '%{http_code}' "$INDEX")" == 200 ]] \
  && ok "index: HEAD 200" || fail "index: HEAD is not 200 (the draft says servers MUST support HEAD)"
body="$(cat "$tmp")"
jq -e --arg s "$SCHEMA" '."$schema" == $s' <<<"$body" >/dev/null \
  && ok "index: \$schema is the 0.2.0 URI" || fail "index: missing or unexpected \$schema"
jq -e '.skills | type == "array" and length > 0' <<<"$body" >/dev/null 2>&1 \
  && ok "index: skills[] has entries" || fail "index: skills[] is missing or empty"

# 2. Каждая запись: поля, URL, медиатип, name во front-matter и digest
while read -r entry; do
  name="$(jq -r '.name // ""' <<<"$entry")"; url="$(jq -r '.url // ""' <<<"$entry")"
  want="$(jq -r '.digest // ""' <<<"$entry")"
  type="$(jq -r '.type // ""' <<<"$entry")"
  jq -e '.description | type == "string" and length > 0 and length <= 1024' <<<"$entry" >/dev/null \
    || fail "$name: description is missing or longer than 1,024 characters"
  [[ "$type" == skill-md ]] || { fail "$name: type is '$type'; this script verifies skill-md entries only"; continue; }
  [[ "$name" =~ ^[a-z0-9]+(-[a-z0-9]+)*$ && ${#name} -le 64 ]] || fail "$name: invalid name"
  [[ "$want" =~ ^sha256:[0-9a-f]{64}$ ]] || fail "$name: digest is not sha256:<64 lowercase hex>"
  case "$url" in https://*|http://*) ;; /*) url="$ORIGIN$url" ;; *) url="$ORIGIN/.well-known/agent-skills/$url" ;; esac
  [[ "$url" == https://* && "$url" != *localhost* ]] || { fail "$name: url is not a public https URL ($url)"; continue; }

  meta="$(curl -sS -o "$tmp" -w '%{http_code} %{content_type}' "$url")"
  [[ "$meta" == 200\ text/markdown* || "$meta" == 200\ text/plain* ]] \
    && ok "$name: GET 200, ${meta#* }" || fail "$name: GET -> $meta"
  got="sha256:$(shasum -a 256 "$tmp" | cut -d' ' -f1)"
  [[ "$got" == "$want" ]] && ok "$name: digest matches the served bytes" \
    || fail "$name: digest drift - index says $want, served bytes hash to $got"
  head -n 10 "$tmp" | tr -d '\r' | grep -qx "name: $name" \
    && ok "$name: front-matter name matches" || fail "$name: front-matter name differs from the index"
done < <(jq -c '.skills[]?' <<<"$body" 2>/dev/null)

exit "$bad"
Запущенный на продакшен-сайте aiSiteReady 2 октября 2026 года, он вывел вот это.
ok    index: GET 200, application/json; charset=utf-8
FAIL  index: HEAD is not 200 (the draft says servers MUST support HEAD)
ok    index: $schema is the 0.2.0 URI
ok    index: skills[] has entries
ok    scan-url: GET 200, text/markdown; charset=utf-8
ok    scan-url: digest matches the served bytes
ok    scan-url: front-matter name matches
Эта ошибка была настоящей, и она была нашей. На 2 октября 2026 года наши well-known-маршруты были обработчиками только для GET, и запрос HEAD к ним возвращал 404, тогда как черновик требует поддерживать оба метода. Клиент, который перед загрузкой шлёт HEAD, неверно оценил бы наш сайт. Исправление оказалось небольшим: файлы маршрутов лишились суффикса .get, и один обработчик теперь отвечает на GET и HEAD с одинаковыми статусом и заголовками, так что эта строка выглядит как ok index: HEAD 200. Заметил я ошибку только потому, что написал этот скрипт, — так что запустите свой, прежде чем доверять собственной настройке.
Какие ошибки ломают индекс Agent Skills?
Чаще всего индекс ломают дрейф digest, расплывчатый description и localhost в url, и почти все такие поломки тихие: клиент пропускает навык или сканер понижает оценку проверки. Вот что я бы проверил в первую очередь.
| Ошибка | Что происходит | Как исправить |
|---|---|---|
| Дрейф digest | Клиенты, соблюдающие спецификацию, отказываются от навыка, а вы ничего не видите | Считайте digest от отдаваемых байтов |
Расплывчатый description | Агент никогда не выберет навык | Скажите, что он делает, и «Use when» |
| Навык, требующий логина | Агент застревает на первом шаге | Опишите, как получить доступ, или не публикуйте |
localhost или dev-порт в url | Наша проверка отклоняет URL (имя без точки или порт не 80/443) и даёт PARTIAL; staging-хост проверку проходит, но отправляет агентов на staging | Задайте публичный origin или используйте пути от корня |
HTML-оболочка с кодом 200 вместо отсутствующего файла | Клиент без проверки загрузит HTML как инструкции | Возвращайте 404 |
Нет $schema или выдуманный | Установщик, чей код я читал, считает отсутствующий старым 0.1.0, а незнакомый пропускает; без него наша проверка даёт PARTIAL, а любую непустую строку, даже выдуманную, принимает | Скопируйте URI 0.2.0 точно |
Старая форма 0.1.0 или путь /.well-known/skills/ | Наша проверка смотрит только новый путь | Перейдите на agent-skills/ с type, url, digest |
| Описание в индексе отличается от front-matter | Нарушает SHOULD; агент видит две версии | Генерируйте оба из одного источника |
Последняя строка — ещё одно признание. Наш индекс берёт описание из A2A Agent Card, а в front-matter у SKILL.md стоит другая, более длинная фраза. Обе точны, но черновик говорит, что им СЛЕДУЕТ (SHOULD) совпадать. Скрипт сборки выше обходит проблему: он читает описание прямо из front-matter.
Как aiSiteReady проверяет индекс Agent Skills?
Проверка agent_skills в aiSiteReady делает один запрос к /.well-known/agent-skills/index.json и валидирует его по Agent Skills Discovery 0.2.0: структуру, пять полей и формат digest, но не сам отдаваемый SKILL.md. Остальное покрывает ваш скрипт. Она входит в категорию Protocol/API рядом с проверками MCP Server Card и каталога API, а аудит за 30 минут показывает, какое место она занимает в полном аудите.
| Статус | Условие |
|---|---|
| PASS | $schema объявлен, content type — JSON, и есть хотя бы одна запись с валидными name, type, description, url и digest |
| PARTIAL | Валидные записи есть, но нет $schema или индекс отдан с не-JSON типом вроде text/plain; записи есть, но ни одна не валидна; skills отсутствует или пуст; либо JSON не парсится |
| UNKNOWN | Индекс не удалось безопасно загрузить; 403 или 429 считается блокировкой, а не вердиктом |
| FAIL | Индекса нет: 404 или другой код ошибки, кроме 403/429, либо HTML-страница (оболочка SPA или JSON с типом text/html) вместо JSON |
Четыре ограничения, которые стоит знать:
- Проверка делает один запрос и никогда не скачивает
SKILL.md, поэтому валидирует формат digest, но не поймает дрейф; для этого и нужен ваш скрипт. - Она смотрит только well-known-путь, без поиска через заголовок
Link. - Категория Protocol/API выключена в профиле Контентный сайт, так что проверка учитывается только в профиле по умолчанию Все проверки и в профилях API/приложение и Интернет-магазин.
- URL записей должны быть абсолютными http(s)-URL (или разрешаться в такой относительно URL индекса) с доменным именем, содержащим точку, и портом 80 или 443. Проверка их не резолвит и не скачивает, поэтому
http://localhost:5173/…не проходит, а staging-хост или приватный IP пройдут.
Сколько весит категория Protocol/API (там она называется «Протоколы») в каждом профиле, показано на странице методологии.
Запустите бесплатное сканирование, чтобы увидеть, находит ли агент ваш индекс навыков, какие записи проходят проверку и что исправить в первую очередь — на английском, украинском или русском. А полный набор слоёв начинается со статьи о том, что значит готовность к ИИ-агентам.
Если коротко: навык — это SKILL.md, где сказано, когда его применять и что именно вызывать; индекс — пять полей на запись; а digest нужно считать от тех байтов, которые вы отдаёте. Пишите описание как триггер, генерируйте индекс из файлов и запускайте скрипт проверки на каждом релизе.
У IMozz 20 лет в разработке ПО, а последний год он строит продукты с помощью LLM. Он развивает aiSiteReady, сканер только для чтения, который проверяет, может ли ИИ-агент прочитать и вызвать сайт. Сканер серверно рендерит собственный контент как рабочий пример.