Аудит готовности к ИИ-агентам: проверка сайта за 30 минут
Аудит готовности к ИИ-агентам за 30 минут: шесть блоков curl-команд (доступ, контент, обнаружение, данные, API, правила) и один скрипт на все проверки.
Аудит готовности к ИИ-агентам для своего сайта занимает около 30 минут проверок: шесть пятиминутных блоков, один терминал и несколько команд curl, которые покажут, могут ли ИИ-агенты дойти до сайта, прочитать его, найти, понять и вызвать. Оценка результатов и выбор, что чинить, займут ещё около 10 минут.
Каждая команда ниже настоящая. Я прогнал их все на нашем рабочем сайте www.ai-siteready.com 2 и 3 октября 2026 года, а выводы — это урезанные копии того, что вернулось.
Сканер автоматизирует всё это, но один раз пройти руками полезно: видно, как каждый сигнал выглядит на уровне HTTP, и автоматическому отчёту проще доверять. Блоки идут в том порядке, в каком бот встречает ваш сайт: сначала доступ, потому что остальное не имеет значения, если файрвол блокирует бота, и вызов в конце, потому что большинству сайтов он пока не нужен. Саму идею стека объясняет статья что такое готовность к ИИ-агентам.
Ключевые выводы
- Аудит состоит из шести блоков (доступ, чтение, обнаружение, понимание, вызов, правила). Вместе они затрагивают все 21 проверку сканера aiSiteReady.
- Начинайте с доступа и чтения. Бот, получивший 403 или пустую JavaScript-оболочку, остального не увидит, а анализ Vercel от декабря 2024 года показал, что краулеры OpenAI, Anthropic и Perplexity не рендерят JavaScript (Vercel).
- В ранних блоках большинство сайтов проходит, в поздних — почти никто. Cloudflare в апреле 2026 года просканировал 200 000 самых посещаемых доменов:
robots.txtесть у 78%, около 4% объявляют предпочтения по ИИ, а Markdown-согласование проходят 3,9% (Cloudflare).- Не все промахи равнозначны. Google пишет, что специальные файлы для ИИ не нужны, а Google Search игнорирует
llms.txt(Google). Приоритизируйте по влиянию и трудозатратам.- Ручной аудит — это снимок. Автоматизируйте его, когда шаблонов много или вы часто выкатываете релизы.
Что входит в 30-минутный аудит готовности к ИИ-агентам?
Шесть блоков, каждый нацелен на свой тип сбоя. aiSiteReady группирует проверки в пять категорий: Обнаруживаемость, Доступность контента, Правила для ботов, Protocol/API, Коммерция. Аудит проходит по ним в том порядке, в каком краулер встречает сайт, поэтому одна категория может растянуться на два блока.
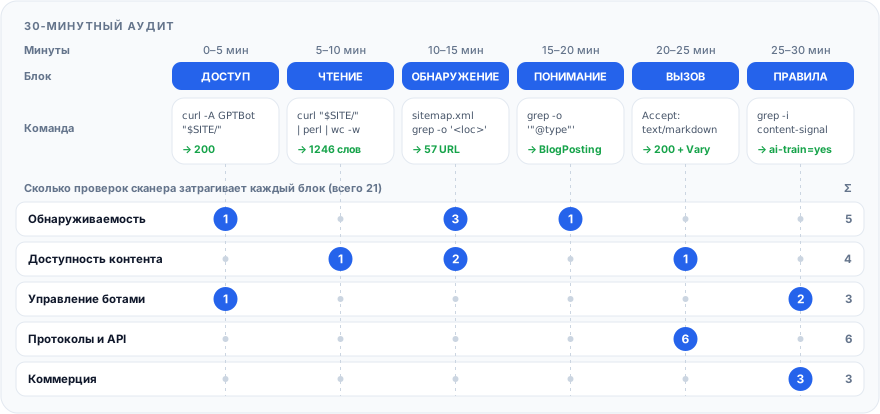
Нужны curl и perl, они есть в macOS и в большинстве дистрибутивов Linux. Подставьте в переменную свой сайт и только свой: дальше команды отправляют user agent краулеров, и это нормально для проверки собственных правил, но не для чужого сервера.
Проверки страниц запускайте на главной и на одном URL каждого шаблона, например статьи или карточки товара: проблема часто живёт только в одном шаблоне. Вторая строка ниже проходит по редиректам, так что голый домен или адрес с http:// сводится к тому origin, который реально отвечает.
export SITE=https://www.example.com    # ваш сайт, без слэша в конце
SITE=$(curl -sS -L -o /dev/null -w '%{url_effective}' "$SITE/" | sed -E 's#^(https?://[^/]+).*#\1#')    # apex -> www, http -> https
hdr() { curl -sS -D - -o /dev/null "$@" | tr -d '\r'; }    # GET, печатаем только заголовки
Как проверить, что ИИ-боты могут дойти до вашего сайта? (минуты 0–5)
Запросите главную страницу и robots.txt как обычно, затем повторите запрос главной с user agent ИИ-краулеров. Каждый ответ должен быть обычным 200 либо отказом, который вы выбрали осознанно.
curl -sS -o /dev/null -L -w 'status=%{http_code} redirects=%{num_redirects} time=%{time_total}s\n' "$SITE/"
curl -sS -o /dev/null -L -w 'robots.txt: %{http_code} %{content_type}\n' "$SITE/robots.txt"
for bot in GPTBot OAI-SearchBot ClaudeBot PerplexityBot; do
  printf '%-15s ' "$bot"
  curl -sS -o /dev/null -L -A "Mozilla/5.0 (compatible; $bot/1.0)" -w '%{http_code}\n' "$SITE/"
done
status=200 redirects=0 time=0.318752s
robots.txt: 200 text/plain; charset=utf-8
GPTBot          200
OAI-SearchBot   200
ClaudeBot       200
PerplexityBot   200
| Сигнал | Хорошо | Плохо |
|---|---|---|
| Главная страница | 200, не больше одного редиректа | 403, 429, 5xx, цепочка редиректов |
robots.txt | 200, text/plain, правила, которые вы писали | 5xx, 429 или таймаут; HTML по этому пути |
| User agent ботов | тот же 200, что получает браузер | 403, 429, страница-проверка |
| Правила Disallow | ничего лишнего | Disallow: / для ИИ-бота |
В строке про robots.txt скрыта асимметрия. По RFC 9309, если файл недоступен (4xx), краулер может обращаться к любым ресурсам, но если он недостижим из-за ошибки сервера или сети, краулер обязан считать, что закрыто всё (RFC 9309). Google считает любой 4xx, кроме 429, отсутствующим файлом (Google), поэтому 429 засчитывайте как FAIL. Сломанный robots.txt хуже, чем отсутствующий. Теперь поищите сплошную блокировку, которую кто-то мог добавить случайно:
curl -sS "$SITE/robots.txt" | tr -d '\r' | awk '{l=$0; sub(/#.*/,"",l); gsub(/[ \t]/,"",l); k=tolower(l)} k==""{next} k~/^user-agent:/{if(!g)u=""; g=1; u=u" "substr(l,12); next} {g=0} k=="disallow:/"{print substr(u,2)" -> Disallow: /"}'
На нашем сайте команда ничего не печатает, и это хороший результат. Если дать ей файл, закрывающий обучающий краулер OpenAI, она напечатает GPTBot -> Disallow: /. Группа, в которой названо несколько ботов, выводится одной строкой, а Disallow:/ без пробела тоже распознаётся.
Отсутствие случайной блокировки ещё не значит, что проверка сканера ai_bot_rules пройдена. Ей нужны именованные группы для OAI-SearchBot, Claude-SearchBot и PerplexityBot плюс явное разрешение или запрет хотя бы для одного обучающего краулера: GPTBot, ClaudeBot или CCBot. Одна группа User-agent: * даёт в ней лишь частичный результат. Команда grep -i '^user-agent' по вашему robots.txt покажет, какие группы у вас есть.
Цикл по user agent проверяет только правила, завязанные на строку user agent, и отправляет имя краулера с вашего собственного IP-адреса. Файрволы фильтруют ещё и по IP-адресу, и по bot score, а OpenAI публикует IP-диапазоны каждого краулера (OpenAI). Файрвол с защитой от ботов может заблокировать запрос, который представляется краулером, но приходит не из его опубликованных IP-диапазонов, и при этом пропустить настоящий краулер.
Поэтому 403 на поддельный user agent — подсказка, которую нужно сверить с логами файрвола, а не доказательство блокировки, а 200 необходим, но недостаточен. Anthropic добавляет, что блокировка по IP может помешать её ботам вообще прочитать robots.txt (Anthropic). После смены правил подождите: OpenAI сообщает, что её системам может потребоваться около 24 часов, чтобы обновить результаты поиска (OpenAI).
Соответствующие проверки сканера: robots_txt и ai_bot_rules.
Может ли ИИ-агент прочитать страницу без JavaScript? (минуты 5–10)
Загрузите страницу так, как это делает простейший краулер, без JavaScript, и посчитайте уцелевшие слова. Фильтр на perl выбрасывает блоки script, style, template и SVG, а затем убирает остальные теги.
curl -sS -L "$SITE/" | perl -0777 -pe 's/<(script|style|noscript|template|svg)\b.*?<\/\1>//gsi; s/<[^>]+>/ /gs' | wc -w
curl -sS -L "$SITE/" | grep -o -i -E '<(h1|h2|main|title)[ >]' | tr 'A-Z' 'a-z' | sort | uniq -c
1246
   1 <h1
   5 <h2
   1 <main
   1 <title>
Нужны сотни слов, один h1, настоящие заголовки и ваш собственный текст; почти нулевой счётчик и скелет из разметки — повод насторожиться. Я прогнал тот же фильтр по странице, где в body только пустой div и тег script, то есть по классической клиентской оболочке, и он напечатал 0. Именно это получает GPTBot или ClaudeBot от такой страницы. По измерениям Vercel от декабря 2024 года, исключение составляют Gemini и AppleBot: они рендерят страницы (Vercel).
Веб-приложение за логином покажет только оболочку входа, и это ожидаемо. А большой счётчик сам по себе ещё ничего не значит: если слова — это cookie-баннеры и навигация, прочитайте сам текст.
Соответствующая проверка сканера: ssr_content.
Как проверить обнаружение: от sitemap до llms.txt? (минуты 10–15)
Убедитесь, что бот находит ваши страницы без догадок: sitemap, на который указывает robots.txt, один canonical на страницу, связи обнаружения в заголовке Link и, по желанию, llms.txt.
curl -sS "$SITE/robots.txt" | grep -i '^sitemap:'
hdr "$SITE/sitemap.xml" | grep -i -E '^(HTTP|content-type)'
curl -sS "$SITE/sitemap.xml" | grep -o '<loc>' | wc -l
curl -sS "$SITE/" | grep -o '<link[^>]*rel="canonical"[^>]*>'
hdr "$SITE/" | grep -i '^link:'
hdr "$SITE/llms.txt" | grep -i -E '^(HTTP|content-type)'
hdr "$SITE/llms-full.txt" | grep -i -E '^(HTTP|content-type)'
Sitemap: https://www.ai-siteready.com/sitemap.xml
HTTP/2 200
content-type: application/xml; charset=utf-8
57
<link id="i18n-can" rel="canonical" href="https://www.ai-siteready.com">
link: </sitemap.xml>; rel="sitemap", </llms.txt>; rel="describedby", </site.webmanifest>; rel="manifest", </.well-known/api-catalog>; rel="api-catalog"
HTTP/2 200
content-type: text/markdown; charset=utf-8
HTTP/2 200
content-type: text/markdown; charset=utf-8
Сравните вывод с тем, как выглядит хороший и плохой результат:
| Сигнал | Хорошо | Плохо |
|---|---|---|
| Sitemap | XML, ненулевое число <loc>, указан в robots.txt | 404, HTML-страница с ответом 200, URL со staging-домена |
| Canonical | один абсолютный URL, совпадающий со страницей | отсутствует, задвоен или расходится с sitemap |
llms.txt | 200 с text/markdown или text/plain | HTML по этому пути, который часто отдаёт маршрут-заглушка (catch-all) |
Заголовок Link — самый дешёвый сигнал: RFC 8288 определяет его как способ сериализовать ссылки в HTTP-заголовки, и каждая ссылка обязана нести rel (RFC 8288). Наш заголовок указывает на sitemap, llms.txt и каталог API, и клиенту не нужно разбирать HTML.
С llms.txt — без иллюзий. В предложении обязателен только H1, за ним идут краткое резюме в цитате и разделы со ссылками (llmstxt.org); это предложение, а не стандарт. Ahrefs выяснил, что около 28% из 137 000 доменов в его данных Web Analytics публикуют такой файл, а 97% этих файлов за май 2026 года не получили ни одного запроса (Ahrefs). Публиковать его дёшево, но это плохая причина откладывать то, что выше по списку.
Соответствующие проверки сканера: sitemap, canonical_metadata, link_headers, llms_txt, llms_full_txt.
Говорят ли ваши структурированные данные, кто и когда это написал? (минуты 15–20)
Выведите типы JSON-LD из сырого HTML и проверьте, что у статьи есть автор и даты. В ARTICLE подставьте любую статью своего сайта; у нас это была /blog/serve-markdown-to-ai-agents. Структурированные данные, которые скрипт подставляет после загрузки, в этот вывод не попадут, и в этом весь смысл.
ARTICLE="$SITE/path/to/an/article"    # любая статья вашего сайта
curl -sS "$SITE/" | grep -o '"@type": *"[^"]*"' | sort | uniq -c
curl -sS "$ARTICLE" | grep -o -E '"(datePublished|dateModified)": *"[^"]*"|"author": *\{[^}]*\}'
  10 "@type":"Answer"
   1 "@type":"FAQPage"
   1 "@type":"ImageObject"
   1 "@type":"Offer"
   1 "@type":"Organization"
  10 "@type":"Question"
   1 "@type":"SoftwareApplication"
   1 "@type":"WebSite"
"datePublished":"2026-06-07"
"dateModified":"2026-06-07"
"author":{"@type":"Person","name":"IMozz","url":"https://github.com/i-mozz"}
На главной должны быть Organization и WebSite, а в каждой статье — BlogPosting с автором Person, datePublished и dateModified. Google называет эти три свойства рекомендуемыми для Article и ни одно не считает обязательным (Google). Ищите пустой вывод, даты только в видимом тексте или автора «admin». У интернет-магазинов здесь должен появиться и Product. Для статей см. чек-лист автора, даты и JSON-LD.
Соответствующая проверка сканера: generic_structured_data.
Может ли агент вызывать возможности вашего сайта? (минуты 20–25)
Запросите Markdown, а затем проверьте well-known пути, где объявляются агентские эндпоинты. Контентным сайтам вторую половину можно пролистать: она важна продуктам с API или инструментами.
hdr -H 'Accept: text/markdown' "$SITE/" | grep -i -E '^(HTTP|content-type|vary)'
for p in api-catalog agent-skills/index.json ai-catalog.json mcp/server-card.json agent-card.json \
         oauth-authorization-server oauth-protected-resource; do
  printf '%-44s ' "/.well-known/$p"
  curl -sS -o /dev/null -L -w '%{http_code} %{content_type}\n' "$SITE/.well-known/$p"
done
HTTP/2 200
content-type: text/markdown; charset=utf-8
vary: Accept-Encoding
vary: Accept
/.well-known/api-catalog                     200 application/linkset+json; charset=utf-8; profile="https://www.rfc-editor.org/info/rfc9727"
/.well-known/agent-skills/index.json         200 application/json; charset=utf-8
/.well-known/ai-catalog.json                 404 application/json
/.well-known/mcp/server-card.json            200 application/json; charset=utf-8
/.well-known/agent-card.json                 200 application/json; charset=utf-8
/.well-known/oauth-authorization-server      404 application/json
/.well-known/oauth-protected-resource        404 application/json
С Markdown нужен text/markdown вместе с Vary: Accept: так кэш не отдаст Markdown браузеру, а один Vary: Accept-Encoding не в счёт. Если вы не на Cloudflare, см. Markdown без Cloudflare. Читайте результат обхода по коду статуса, а не по типу содержимого: три наши строки с 404 всё равно показывают application/json, потому что тело ошибки — JSON.
| Путь | Что объявляет | Статус стандарта |
|---|---|---|
api-catalog | ваши API со ссылкой на файл OpenAPI | RFC 9727 (RFC 9727) |
ai-catalog.json | ИИ-артефакты, включая MCP Server Card | черновик; точка входа для обнаружения в черновике MCP |
mcp/server-card.json | MCP-сервер и его эндпоинт | экспериментальный, не официальное расширение; старый путь (репозиторий MCP) |
agent-skills/index.json | навыки, которые может загрузить агент | Draft 0.2.0 (репозиторий спецификации) |
oauth-* | метаданные OAuth-сервера и ресурса | RFC 8414 и RFC 9728 (RFC 8414, RFC 9728) |
Тип сайта определяет, что значит 404. Сайт без OAuth-защищённого API должен получить 404 в обеих строках OAuth, и у нас так и есть; сайт, где работает OAuth, должен получить 200. Сканер считает такой 404 неприменимым, если не видит признаков OAuth, но не в профиле API/приложение: там 404 — FAIL даже для сервиса, который работает только с API-ключами.
Карточка MCP переехала. Текущий черновик разрешает размещать карточку по любому незарезервированному URI, рекомендует <mcp-url>/server-card и строит обнаружение через /.well-known/ai-catalog.json; путь /.well-known/mcp/server-card в нём рассмотрен и не рекомендован (discovery.md). Сканер aiSiteReady всё ещё проверяет старый путь, а наш сайт пока отдаёт карточку там же и без AI Catalog. Подробности — в статье MCP Server Card.
digest в Agent Skills — это SHA-256, поэтому команда curl -sS "$SITE/.well-known/agent-skills/scan-url/SKILL.md" | shasum -a 256 должна напечатать hex-часть значения sha256: из индекса; на нашем сайте так и происходит. Поддержка всего этого у агентов неравномерна, а часть спецификаций — черновики.
Соответствующие проверки сканера: markdown_negotiation, api_catalog, mcp_server_card, agent_skills, a2a_webmcp_readiness, oauth_authorization_server, oauth_protected_resource.
Какие правила использования, лимиты и данные о товарах вы публикуете? (минуты 25–30)
Последний блок: сказать агентам, что им можно, как быстро и, если вы что-то продаёте, что именно.
curl -sS "$SITE/robots.txt" | grep -i -E '^content-(signal|usage)'
hdr "$SITE/" | grep -i '^content-usage:' || echo 'content-usage header: none'
curl -sS -o /dev/null -w 'tdmrep: %{http_code}\n' "$SITE/.well-known/tdmrep.json"
hdr "$SITE/" | grep -i -E '^(ratelimit|ratelimit-policy|retry-after)'
curl -sS -o /dev/null -w 'ucp: %{http_code}\n' "$SITE/.well-known/ucp"
Content-Signal: search=yes, ai-input=yes, ai-train=yes
content-usage header: none
tdmrep: 404
ratelimit-policy: "scan";q=20;w=60
ucp: 404
Предпочтения по использованию. Content Signals, опубликованные Cloudflare в сентябре 2025 года, добавляют в robots.txt строку Content-Signal с тремя сигналами — search, ai-input и ai-train, каждый со значением yes или no (Cloudflare). У нас разрешены все три. Собственный словарь IETF с метками train-ai, ai-use и search пока остаётся Internet-Draft (ревизия 08, сентябрь 2026) и может измениться (IETF aipref).
Вариант IETF передаётся строкой Content-Usage в robots.txt или заголовком ответа Content-Usage, поэтому блок проверяет оба места. Наш сайт, как видно из вывода, не публикует ни то ни другое, а сканер aiSiteReady пока тоже не читает Content-Usage. Любое явное машиночитаемое предпочтение лучше молчания.
Подсказки о лимитах. Черновик IETF для заголовков RateLimit-Policy и RateLimit сейчас в ревизии 11 (май 2026) и не является RFC; его пример — RateLimit-Policy: "default";q=100;w=10, то есть квота 100 за 10 секунд (IETF). Наш заголовок объявляет политику scan: 20 запросов за 60 секунд — это публичный лимит на запуск скана. Синтаксис, обработка 429 и готовые конфигурации для серверов описаны в руководстве по RateLimit-Policy.
Коммерция зависит от типа сайта. aiSiteReady — SaaS-инструмент, поэтому 404 на /.well-known/ucp для нас корректен. На нашей главной есть Offer с ценой, но нет Product, а одиночный оффер не считается данными о товаре. Для магазина запустите команду с @type из блока 4 на странице товара и ждите Product плюс Offer с price и priceCurrency.
Проверка сканера по фидам товаров также ищет подсказки о фидах в заголовках и метаданных. UCP — протокол, который Shopify и Google анонсировали в январе 2026 года, — размещает профиль продавца по адресу /.well-known/ucp (Shopify, UCP). Шаги описаны в статье как опубликовать профиль UCP.
Соответствующие проверки сканера: content_usage_policy, rate_limit_hints, product_structured_data, product_feed_hints, agentic_commerce_signals.
Как оценить аудит и решить, что чинить первым? (минуты 30–40)
Оценивайте каждую строку так же, как сканер: PASS — 1, PARTIAL — 0,5, FAIL — 0, а строка, которая к сайту не относится, выпадает. aiSiteReady к тому же взвешивает проверки по важности (high ×2, medium ×1, low ×0,5) и сворачивает категории по профилю в оценку Agent Readiness Score от 0 до 100 и уровень от 0 до 5 (методология).
Проверка, которую не удалось завершить, получает статус unknown — «не удалось проверить», а не «провалено», поэтому перепроверьте её: пока вы этого не сделали, она даёт 0, как FAIL, и остаётся в общем счёте. Профиль Контентный сайт придаёт категориям Protocol/API и Коммерция нулевой вес, так что эти строки можно пропустить.
Заполните рабочую таблицу, по строке на проверку. Вес — это важность проверки в сканере: H, M или L, а прочерк значит, что отдельной проверки в сканере нет. Веса взяты из сканера; в моей приоритизации ниже llms.txt стоит ниже намеренно.
| Проверка | Команда | Пройдена, когда | Вес | Исправление |
|---|---|---|---|---|
| 1 · доступ ботов | цикл curl -A | тот же 200, что у браузера, для каждого user agent ИИ | — | настройки ботов в файрволе или CDN |
| 1 · правила для ИИ-ботов | awk, grep '^user-agent' | именованные группы для поисковых ботов, явное решение по обучению, нет случайной блокировки | H | руководство по robots.txt |
1 · robots.txt | %{http_code}, %{content_type} | 200 text/plain или осознанный 404; никогда 5xx или 429 | H | руководство по robots.txt |
| 2 · контент в сыром HTML | счётчик слов perl | сотни слов, один h1 | H | JavaScript-сайты |
| 3 · sitemap | grep -o '<loc>' | XML, ненулевое число, указан в robots.txt | H | поиск страниц |
| 3 · canonical, заголовок Link | grep, hdr | один абсолютный canonical; связи обнаружения | L, M | поиск страниц |
3 · llms.txt | hdr | 200, Markdown, H1, резюме, ссылки | H | llms.txt |
| 4 · JSON-LD | grep '@type' | Organization, WebSite; у статей автор и даты | M | структурированные данные |
| 5 · Markdown | заголовок Accept | text/markdown и Vary: Accept | H | Markdown |
| 5 · каталог API | обход well-known | 200 linkset+json со ссылкой на файл OpenAPI | M | каталог API |
| 5 · MCP, skills, A2A | обход well-known | 200 JSON, если вы публикуете эту поверхность | M | вызов агентами |
| 5 · метаданные OAuth | обход well-known | 200, если у вас есть OAuth; профиль API/приложение его ждёт | M | OAuth |
| 6 · правила использования | grep content- | явный машиночитаемый сигнал | M | правила использования |
| 6 · подсказки о лимитах | hdr | RateLimit-Policy или Retry-After | L | лимиты |
| 6 · только магазины | страница товара, ucp | Product и Offer с ценой; профиль отдаёт 200 | M, L | коммерция |
Затем отсортируйте провалы по влиянию (сколько в стеке блокирует промах) и трудозатратам (сколько времени займёт исправление). Расстановка ниже качественная и рассчитана на типичный контентный сайт; у API-продукта протокольные пункты поднимутся выше.
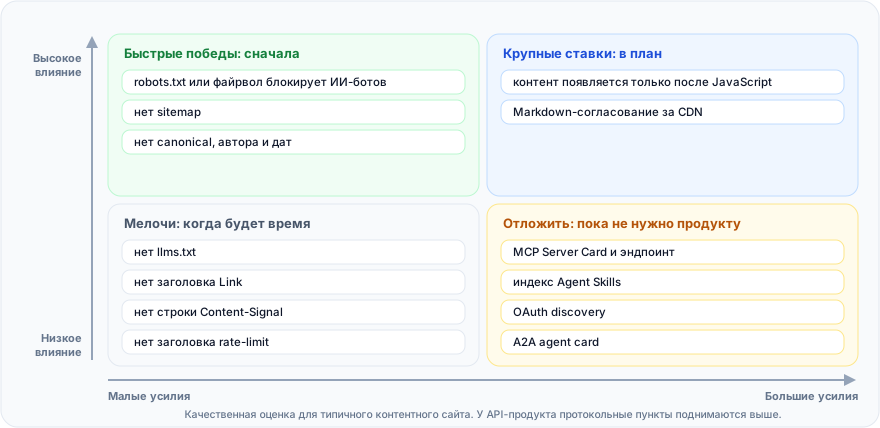
Идите по верхнему ряду слева направо. Правило, блокирующее ботов, часто исправляется одной строкой и разблокирует всё остальное. Сайт с клиентским рендерингом — это проект, но без него остальному стеку нечего описывать. Нижний ряд — доработки и задачи, зависящие от продукта. Перезапускайте аудит после каждого исправления.
Можно ли запустить весь аудит одним скриптом?
Да, для всего, что сводится к заголовку или совпадению в теле. Скрипт выполняет быстрые проверки из всех шести блоков и печатает для каждой PASS, WARN, FAIL или INFO: FAIL — блокирующая проблема, WARN — стоит исправить, INFO — необязательно или зависит от продукта. Пороги по числу слов — моё практическое правило, а не пороги сканера.
Сначала скрипт проходит по редиректам от переданного URL, так что голый домен или адрес с http:// проверяется на том origin, который отвечает. Ещё он смотрит на тип содержимого, а не только на код статуса: одностраничное приложение может отвечать 200 с HTML на любой путь.
#!/usr/bin/env bash
# agent-audit.sh - быстрая проверка готовности к ИИ-агентам. Тестируйте только свои сайты.
# Usage: ./agent-audit.sh https://www.example.com
set -u
SITE="${1:?usage: agent-audit.sh https://www.example.com}"
SITE="${SITE%/}"
# Audit the origin the home page lands on (apex -> www, http -> https).
SITE=$(curl -sS -m 10 -L -o /dev/null -w '%{url_effective}' "$SITE/" 2>/dev/null | sed -E 's#^(https?://[^/]+).*#\1#')
pass=0; warn=0; fail=0
ok()   { printf 'PASS  %s\n' "$1"; pass=$((pass+1)); }
warn() { printf 'WARN  %s\n' "$1"; warn=$((warn+1)); }
bad()  { printf 'FAIL  %s\n' "$1"; fail=$((fail+1)); }
info() { printf 'INFO  %s\n' "$1"; }
code() { curl -sS -L -m 10 -o /dev/null -w '%{http_code}' "$@" 2>/dev/null; }
ctyp() { curl -sS -L -m 10 -o /dev/null -w '%{http_code} %{content_type}' "$@" 2>/dev/null; }
hdrs() { curl -sS -L -m 10 -D - -o /dev/null "$@" 2>/dev/null | tr -d '\r'; }
body() { curl -sS -L -m 10 "$@" 2>/dev/null; }

# 1. REACH
c=$(code "$SITE/")
[ "$c" = 200 ] && ok "home returns 200" || bad "home returned $c"
c=$(ctyp "$SITE/robots.txt")
case "$c" in
  "200 text/plain"*) ok "robots.txt returns 200 text/plain" ;;
  200*) warn "robots.txt returns 200 as ${c#200 } (HTML catch-all?)" ;;
  429*) bad "robots.txt returned 429 (Google treats it like a 5xx)" ;;
  4??*) warn "robots.txt returned ${c%% *} (no rules: crawlers may fetch everything)" ;;
  *)    bad "robots.txt returned ${c%% *} (5xx/unreachable = crawlers assume full disallow)" ;;
esac
for bot in GPTBot OAI-SearchBot ClaudeBot PerplexityBot; do
  c=$(code -A "Mozilla/5.0 (compatible; $bot/1.0)" "$SITE/")
  [ "$c" = 200 ] && ok "UA $bot gets 200" || bad "UA $bot gets $c (user-agent rule? confirm in firewall logs)"
done

# 2. READ
html=$(body "$SITE/")
words=$(printf '%s' "$html" | perl -0777 -pe 's/<(script|style|noscript|template|svg)\b.*?<\/\1>//gsi; s/<[^>]+>/ /gs' | wc -w | tr -d ' ')
if   [ "$words" -ge 200 ]; then ok "$words words in raw HTML"
elif [ "$words" -ge 50 ];  then warn "only $words words in raw HTML"
else bad "$words words in raw HTML (JavaScript shell?)"; fi
printf '%s' "$html" | grep -qi '<h1[ >]' && ok "an h1 is in the raw HTML" || bad "no h1 in the raw HTML"

# 3. DISCOVER
if body "$SITE/robots.txt" | grep -qi '^sitemap:'; then ok "robots.txt lists a Sitemap"; else warn "no Sitemap line in robots.txt"; fi
body "$SITE/sitemap.xml" | grep -qiE '<(urlset|sitemapindex)' && ok "sitemap.xml parses as a sitemap" || warn "no sitemap at /sitemap.xml"
printf '%s' "$html" | grep -qiE '<link[^>]+rel="canonical"' && ok "canonical link found" || warn "no canonical link"
hdrs "$SITE/" | grep -qiE '^link:.*rel="?(sitemap|api-catalog|describedby|alternate)' && ok "Link header advertises discovery relations" || info "no discovery Link header"
case "$(ctyp "$SITE/llms.txt")" in
  "200 text/markdown"*|"200 text/plain"*) ok "llms.txt exists (optional)" ;;
  *) info "no llms.txt (optional)" ;;
esac

# 4. UNDERSTAND
n=$(printf '%s' "$html" | grep -oi 'application/ld+json' | wc -l | tr -d ' ')
[ "$n" -ge 1 ] && ok "$n JSON-LD block(s) in raw HTML" || warn "no JSON-LD in raw HTML"

# 5. CALL
h=$(hdrs -H 'Accept: text/markdown' "$SITE/")
if printf '%s' "$h" | grep -qi '^content-type: text/markdown'; then
  printf '%s' "$h" | grep -qiE '^vary:(.*[ ,])?accept *(,|$)' && ok "Markdown negotiation with Vary: Accept" || warn "Markdown served but no Vary: Accept"
else info "no Markdown negotiation on /"; fi
for p in /.well-known/api-catalog /.well-known/agent-skills/index.json /.well-known/ai-catalog.json /.well-known/mcp/server-card.json /.well-known/agent-card.json; do
  case "$(ctyp "$SITE$p")" in
    200*json*) ok "$p found" ;;
    *) info "$p not found (fine unless you ship it)" ;;
  esac
done

# 6. GOVERN
body "$SITE/robots.txt" | grep -qi '^content-signal:' && ok "Content-Signal in robots.txt" || info "no Content-Signal line"
if body "$SITE/robots.txt" | grep -qi '^content-usage:' || hdrs "$SITE/" | grep -qi '^content-usage:'; then
  ok "Content-Usage (aipref) in robots.txt or a header"
else info "no Content-Usage rule or header"; fi
hdrs "$SITE/" | grep -qiE '^(ratelimit|ratelimit-policy|retry-after):' && ok "rate-limit header on /" || info "no RateLimit-Policy header"

printf '\n%s pass, %s warn, %s fail\n' "$pass" "$warn" "$fail"
[ "$fail" -eq 0 ]
Я запустил его на https://www.ai-siteready.com, на голом https://ai-siteready.com и на http://ai-siteready.com, и все три прогона совпали. Каждый напечатал 21 строку PASS и две строки INFO (нет AI Catalog и нет Content-Usage) и закончился строкой 21 pass, 0 warn, 0 fail. Это число строк самого скрипта, а не 21 проверка сканера.
Чистый прогон на нашем сайте сам по себе мало что доказывает: я строил сайт под эти проверки. Показательнее случай с ошибками. На локальной заглушке, которая отдаёт только пустой div и тег script, скрипт заканчивается строкой 5 pass, 5 warn, 2 fail и печатает две строки, которые важнее остальных.
FAIL  0 words in raw HTML (JavaScript shell?)
FAIL  no h1 in the raw HTML
При любом FAIL скрипт завершается с ненулевым кодом, поэтому его можно запускать в CI. Он не оценит качество контента, не проверит JSON-LD по схеме и не отличит настоящую Markdown-страницу от подделки. Здесь и нужен сканер.
Когда автоматизировать аудит готовности к ИИ-агентам?
Переходите на автоматизацию, когда упираетесь в любой из этих пределов:
- больше горстки шаблонов страниц;
- релизы настолько частые, что регрессии вероятны;
- нужны доказательства, которые можно передать разработчику;
- хочется сравнивать сканы во времени.
curl проверяет один URL за раз, а проблема, которая бьёт больнее всего, обычно прячется в шаблоне, который вы пропустили. Браузерные инструменты закрывают другой срез: в Lighthouse, начиная с Chrome 150, есть экспериментальная категория Agentic Browsing — WebMCP, доступность, стабильность вёрстки и машиночитаемое резюме в корне домена (Chrome).
Это и автоматизирует aiSiteReady. Он загружает сырой HTML публичного URL без JavaScript, как простые ИИ-краулеры, под собственным user agent aiAgentReady-Scanner/0.1. Он запускает до 21 проверки, которые покрывают те же области, что и ваши шесть блоков; выбранный профиль (Все проверки, Контентный сайт, API/приложение, Интернет-магазин) определяет, какие из них запускаются и что учитывается. Скан только читает и отправляет каждый запрос через fetcher с защитой от SSRF.
Он возвращает оценку Agent Readiness Score от 0 до 100 с доказательствами по каждой проверке. Если файрвол отвечает сканеру 403 или 429, большинство проверок получают unknown, а не fail, потому что это измеряет доступ сканера, а не ваш сайт. К каждой проваленной или частичной проверке прилагаются понятные рекомендации и готовая задача для разработчика. Проверки, веса и уровни описаны на странице методологии.
Запустите бесплатное сканирование, чтобы увидеть свою оценку, свой уровень и то, какие исправления делать первыми, на английском, украинском или русском.
Сначала доступ и чтение, затем обнаружение и данные, а агентские эндпоинты и правила — когда их требует продукт. Тридцать минут с curl находят проблемы, которые важны, скрипт не даёт им вернуться, а сканирование покрывает страницы, которые вы не проверяли.
У IMozz 20 лет в разработке ПО, а последний год он строит продукты с помощью LLM. Он развивает aiSiteReady, сканер только для чтения, который проверяет, может ли ИИ-агент прочитать сайт. Сканер серверно рендерит собственный контент как рабочий пример.