Content-Usage (aipref) в robots.txt и HTTP: готовые сниппеты
Объявите предпочтения для ИИ через aipref Content-Usage в robots.txt и HTTP-заголовке: train-ai, ai-use, search. Сниппеты и честные ограничения, окт. 2026.
Объявите предпочтения по использованию контента ИИ правилом Content-Usage в robots.txt или HTTP-заголовком Content-Usage, например train-ai=n, search=y. Синтаксис разрабатывает рабочая группа IETF AI Preferences (aipref). Такое заявление выражает намерение и ничего не блокирует. Обе спецификации пока остаются Internet-Draft, и ничто не обязывает краулер их читать (драфт словаря, драфт привязки).
В стеке готовности это один шаг после контроля доступа. robots.txt решает, кто может загрузить страницу (как управлять ИИ-краулерами); предпочтения использования говорят, что краулер, уже загрузивший страницу, может делать дальше: обучать модель, брать как вход для ответа или только индексировать. В отличие от llms.txt, который лишь указывает на контент, здесь выражено разрешение. Это один из слоёв готовности к ИИ-агентам; аудит за 30 минут показывает, как он сочетается с остальными. Статус приведён на октябрь 2026 года.
Ключевые выводы
- Два драфта, RFC пока нет: словарь
-08(14 сентября 2026) и правила привязки-05(19 августа 2026). В тексте словаря сказано, что драфт в целом, и особенно разделы 3 и 4, не отражает консенсус рабочей группы (IETF datatracker).- Три категории, два значения:
train-ai,ai-use,search, каждаяyилиn. Не указано — значит «неизвестно», а значение по умолчанию драфт не называет (словарь -08).- Одна строка, два места: строка
Content-Usageв группеrobots.txtили заголовок ответа (привязка -05).- Ничего не принуждает к исполнению. Получатель сам решает, следовать ли заявлению, а в документации Google по
robots.txtперечислены четыре поддерживаемых поля, и этого поля среди них нет (Google).Content-Signalот Cloudflare — другой словарь (ai-train=no, а неtrain-ai=n). Наше собственное наблюдение по коду: проверкаcontent_usage_policyв aiSiteReady читает Content-Signal, RSL (Really Simple Licensing), TDMRep (TDM Reservation Protocol) иnoai, ноContent-Usageпока не читает.
Что такое Content-Usage и что определяют драфты aipref?
Content-Usage — это название правила в robots.txt и HTTP-заголовка, которые несут короткое заявление о предпочтениях по использованию контента ИИ. Определяют его два Internet-Draft рабочей группы IETF по предпочтениям для ИИ (AI Preferences).
| Драфт | Что определяет | Ревизия | Дата |
|---|---|---|---|
draft-ietf-aipref-vocab | Категории, модель «разрешить/запретить», сериализацию | -08 | 14 сент. 2026 |
draft-ietf-aipref-attach | Правило в robots.txt и HTTP-заголовок | -05 | 19 авг. 2026 |
В словаре три категории, у каждой своя метка строчными буквами (словарь -08).
| Метка | Категория | Что охватывает, кратко по тексту драфта |
|---|---|---|
train-ai | Обучение ИИ | Использование ресурса, чтобы изменить обученные параметры генеративной модели |
ai-use | Использование ИИ | Использование ресурса как входных данных генеративной модели, если их не передал сам пользователь |
search | Поиск | Использование ресурса в приложении, главная цель которого — подобрать ресурсы и направить к ним пользователей |
Заявление присваивает любой из них y (разрешить) или n (запретить) и сериализуется как словарь Structured Fields: члены через запятую, ключи строчными, значения — токены y или n без кавычек (IETF RFC 9651). Так что train-ai=n, search=y значит «не обучайтесь на этом, поиск может использовать» и ничего не говорит про ai-use. Отсутствующий ключ, значение в кавычках "n" или любой токен, кроме y и n, дают «неизвестно», а не ошибку.
Категория search намеренно узкая: она действует, только когда результат ссылается на оригинал, а фрагменты помогают пользователю оценить релевантность. Пересказы и сводки она не покрывает.
Драфты к тому же меняются. После итогового обсуждения в группе обновление за октябрь 2025 описывало категории Foundation Model Production, AI Output и Search (блог IETF); в нынешнем драфте они называются AI Training, AI Use и Search. Срок из устава группы на август 2026 года для передачи обоих документов в IESG (орган IETF, который их утверждает) прошёл. Datatracker по-прежнему показывает оба как документы рабочей группы (IETF datatracker), так что считайте всё сказанное здесь снимком на октябрь 2026 года.
Как объявить Content-Usage в robots.txt?
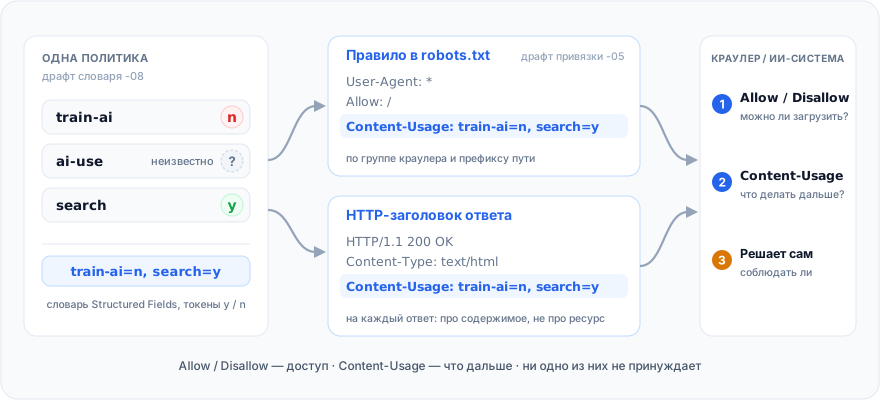
Добавьте одну или несколько строк Content-Usage внутрь группы User-Agent, при необходимости с путём перед предпочтением. Драфт привязки называет это двухэтапной схемой: Allow и Disallow решают, может ли краулер загрузить URL, а Content-Usage говорит, что с содержимым можно делать потом (привязка -05).
User-Agent: *
Allow: /
Disallow: /admin/
Content-Usage: train-ai=n, search=y
Content-Usage: /blog/ train-ai=y, ai-use=y, search=y
Строка без пути действует на всё, что группе можно обходить. Строка, начинающаяся с /, — префикс пути, он сопоставляется так же, как в Allow и Disallow, и побеждает самое длинное совпадение; здесь /blog/ открыт для обучения, остальное закрыто. /admin/ запрещён к обходу, а драфт говорит, что для ресурса, который нельзя обойти, никакое предпочтение не подразумевается.
Три ловушки, прежде чем что-то копировать:
- Именованные группы ничего не наследуют. Краулер следует группе, совпавшей с его токеном продукта, и откатывается к
*, только если ни одна не совпала (IETF RFC 9309). В примере самого драфтаExampleBotпользуется своей группой и не применяет ни одного правила из группы*. Если вы прописываете отдельные группы для ИИ-краулеров, повторяйте строку в каждой группе — так же, как руководство по robots.txt советует делать сDisallow. - Краулеры кэшируют
robots.txt. Драфт допускает до 24 часов, а изменения не применяются задним числом к уже загруженному контенту. - Неизвестные строки игнорируются и могут вызвать предупреждения. Google пропускает поля, которых нет в его списке (Google), а Cloudflare отмечает, что Search Console может сообщать
Syntax not understoodдля новых директив, хотя влияния на обход или SEO не замечено (документация Cloudflare).
User-Agent: *
Allow: /
Content-Usage: train-ai=n, search=y

User-Agent: GPTBot
Allow: /
Content-Usage: train-ai=n, search=y
Как отправлять Content-Usage в HTTP-заголовке?
Отправляйте его в ответе в точно таком же синтаксисе, как значение в robots.txt. Драфт определяет его как метаданные представления: они относятся к содержимому сообщения, а не к ресурсу, работают для любого типа контента и никак особо не влияют на кэширование. Формы для HTML-тега <meta> и других способов встроить предпочтение в страницу драфт не определяет (привязка -05).
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8
Content-Usage: train-ai=n, search=y
В nginx достаточно одной строки в блоке server, чтобы покрыть все ответы, включая картинки и PDF.
# "always" добавляет его и к ответам с ошибками (4xx/5xx).
add_header Content-Usage "train-ai=n, search=y" always;
У nginx есть правило наследования, на котором часто спотыкаются: add_header передаётся вниз, только если на текущем уровне нет своих директив, поэтому location со своим add_header молча теряет этот заголовок (документация nginx). Повторите строку и там. Если заголовки задаёт само приложение, ту же работу делает плагин Nitro, с тем же паттерном beforeResponse, который aiSiteReady уже использует для заголовка RateLimit-Policy.
// server/plugins/content-usage.ts
export default defineNitroPlugin((nitroApp) => {
  nitroApp.hooks.hook("beforeResponse", (event) => {
    // У потокового ответа заголовки уже отправлены.
    if (event.node.res.headersSent) return;
    setResponseHeader(event, "Content-Usage", "train-ai=n, search=y");
  });
});
Заголовок пригодится, когда предпочтения различаются по ответам или типам файлов или когда вы не можете править robots.txt, который покрывает ваш контент. В остальных случаях проще правило в robots.txt: один файл для аудита.
Какую политику публиковать? Три примера
Выберите одно из трёх значений: train-ai=n, search=y (поиск без обучения), train-ai=y, ai-use=y, search=y (разрешить всё) или train-ai=n, ai-use=n, search=n (запретить всё). Скопируйте подходящую строку в оба места. Всё, что вы опустите, остаётся «неизвестным», поэтому укажите категории, которые вам важны.
| Политика | Значение Content-Usage | Что объявляет |
|---|---|---|
| Поиск да, обучение нет | train-ai=n, search=y | Без обучения; поиск разрешён; ai-use не указан |
| Разрешить всё | train-ai=y, ai-use=y, search=y | Все три вида использования приветствуются |
| Закрыть все три | train-ai=n, ai-use=n, search=n | Ни обучения, ни ИИ-входа, ни поиска |
# robots.txt — выберите одну строку внутри группы User-Agent
Content-Usage: train-ai=n, search=y
# Content-Usage: train-ai=y, ai-use=y, search=y
# Content-Usage: train-ai=n, ai-use=n, search=n
Content-Usage: train-ai=n, search=y
«Закрыть все три» не останавливает запрос, а лишь объявляет вашу волю. Чтобы не пускать краулер, нужен Disallow для тех, кто его соблюдает, или правило файрвола для остальных.
search=y шире, чем кажется: по драфту оно охватывает внутреннюю обработку поискового приложения, даже обучение моделей, если результаты ссылаются на источник и показывают фрагменты, помогающие оценить релевантность. Там же сказано, что search перекрывает другие категории там, где они пересекаются. Это правило из раздела 4, а драфт говорит, что текст в целом, и особенно этот раздел, пока не отражает консенсус рабочей группы.
Чем Content-Usage отличается от Content-Signal, TDMRep, RSL и noai?
У каждого механизма свой словарь, поэтому ни один не заменяет другой. Больше всего Content-Usage пересекается с Content Signals Policy от Cloudflare, которую публикуют строкой Content-Signal в robots.txt со значениями yes/no для каждой цели.
| Механизм | Где объявляется | Что выражает | Статус, октябрь 2026 |
|---|---|---|---|
Allow / Disallow | robots.txt | Какие пути краулер может загружать | RFC 9309, Standards Track, 2022 |
| Content-Usage | robots.txt, HTTP-заголовок | train-ai, ai-use, search как y/n | Internet-Draft IETF |
| Content-Signal | robots.txt | ai-train, ai-input, search как yes/no | Текст политики Cloudflare, CC0, анонс 24 сентября 2025 (Cloudflare) |
| TDMRep | HTTP-заголовки, HTML-мета, /.well-known/tdmrep.json | Зарезервированы ли права на text-and-data-mining, плюс URL политики | Final Report из W3C Community Group, 10 мая 2024; не стандарт W3C (W3C) |
| RSL | License: в robots.txt, заголовок Link, HTML | Лицензия с разрешёнными и запрещёнными видами использования и условиями оплаты | RSL 1.0 от 10 декабря 2025, «Recommendation» собственного комитета (RSL) |
noai, noimageai | HTML-тег | Отказ от использования в датасетах для обучения ИИ | Неформальная практика DeviantArt, ноябрь 2022 (TechCrunch) |
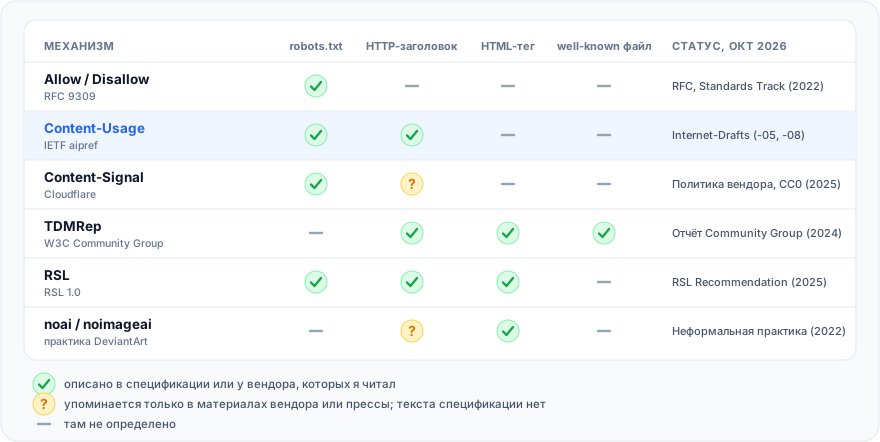
Знак ? в матрице значит, что источник упоминает такое размещение, но не определяет его: например, changelog Cloudflare говорит о заголовке ответа content-signal (changelog Cloudflare), а собственная проверка aiSiteReady читает noai в X-Robots-Tag. Content-Signal и Content-Usage — близкие родственники, и метки у них соотносятся так.
| Cloudflare Content Signals | IETF Content-Usage | Отличие |
|---|---|---|
ai-train=yes или no | train-ai=y или n | Различаются и порядок слов в метке, и токены значений |
ai-input=yes или no | ai-use=y или n | ai-input — это извлечение и заземление; ai-use — вход, который не передал сам пользователь |
search=yes или no | search=y или n | Оба исключают ИИ-сводки; драфт IETF добавляет условие ссылки на источник |
train-ai=no — не валидное предпочтение IETF, потому что учитываются только y и n, поэтому оно молча превращается в «неизвестно». Cloudflare, кроме того, тестирует необязательное четвёртое поле, use=immediate, reference или full, так что и Content Signals ещё развивается (документация Cloudflare). Если публикуете оба, пусть они говорят одно и то же.
Что происходит, когда сигналы конфликтуют?
Внутри Content-Usage драфты отвечают ясно: побеждает более конкретный путь, а там, где значения всё равно спорят, действует самое строгое. Между Content-Usage и всем остальным ни один документ не называет победителя, поэтому никогда не публикуйте противоречий.
- Побеждает более длинный путь. В примере драфта
train-ai=nбез пути покрывает сайт, а/ai-ok/ train-ai=yпереопределяет его для этого поддерева. - Тот же путь, разные значения: побеждает самое строгое. Драфт отмечает, что это отличается от
AllowиDisallow, где ничья решается в пользу более разрешающего варианта (привязка -05, RFC 9309). - Правило в
robots.txtпротив HTTP-заголовка. Драфт привязки приоритета не задаёт. Действует умолчание словаря «при отсутствии другого способа разрешить конфликты»: любой запрет побеждает, затем любое разрешение, иначе неизвестно (словарь -08). Disallowна пути. Предпочтения касаются только ресурсов, которые краулер может загружать.- Договоры сильнее сигналов. Словарь замечает, что лицензия, прямо разрешающая использование, скорее всего, действует вопреки машиночитаемому «нет».
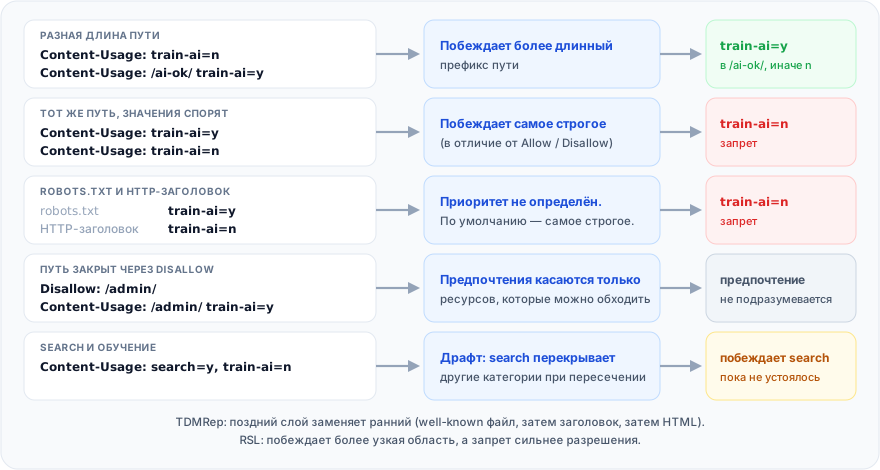
Другие механизмы живут по другим правилам. TDMRep рекомендует правообладателю применять только один способ, а если их несколько, заголовок заменяет well-known файл, а HTML-метаданные заменяют и то и другое (W3C). Правила конфликтов для Content-Signal я в прочитанных материалах Cloudflare не нашёл. Так что если TDMRep резервирует права, а Content-Usage говорит train-ai=y, ни одна спецификация не определяет, какой сигнал побеждает.
Кто на самом деле соблюдает Content-Usage сегодня?
Я не нашёл первоисточника от крупного оператора краулеров, где было бы сказано, что он читает Content-Usage, поэтому считайте поддержку неизвестной и неравномерной. Что удалось проверить:
- Сама спецификация. Она не гарантирует соблюдение предпочтений, оставляет выбор получателю и говорит, что предпочтения — не механизм безопасности (словарь -08).
- Google. В документации по
robots.txtперечисленыuser-agent,allow,disallowиsitemap, остальные поля названы неподдерживаемыми (Google). Задокументированный механизм контроля ИИ — токенGoogle-Extended(Google). - OpenAI. Страница о краулерах описывает
GPTBotиOAI-SearchBotкак независимые токеныrobots.txt; упоминаний Content-Signal или Content-Usage там 2 октября 2026 года я не нашёл (OpenAI). - Cloudflare. Content Signals выражают предпочтения, а не технические меры защиты, и часть компаний может их игнорировать (Cloudflare).
Единственная цифра по внедрению, которую я могу процитировать: по скану топ-200 000 доменов Cloudflare Radar, опубликованному в апреле 2026 года, 4% из них объявили предпочтения по использованию контента ИИ в robots.txt через Content Signals (Cloudflare). По Content-Usage цифры у меня нет.
Поэтому стройте слоями: настоящие токены краулеров для доступа, декларация использования, чтобы ваше намерение было зафиксировано, и правила на сервере или файрволе для реальной блокировки. Юридический вес зависит от юрисдикции; текст Content Signals от Cloudflare подаёт свои ограничения как резервирование прав по директиве ЕС 2019/790 об авторском праве (Cloudflare), так что обсудите свой случай с юристом.
Как проверить настройку Content-Usage?
Запрашивайте файл и заголовок по публичному URL, а не с localhost: прокси, CDN или location в nginx могут изменить то, что видит краулер.
# 1. Правило в robots.txt (заодно покажет строку Content-Signal)
curl -sS https://example.com/robots.txt | grep -iE '^content-(usage|signal):'

# 2. Заголовок ответа на странице
curl -sSI https://example.com/ | grep -i '^content-usage:'

# 3. Тот же заголовок на не-HTML файле из того же стека
curl -sSI https://example.com/logo.png | grep -i '^content-usage:'
Ожидайте Content-Usage: train-ai=n, search=y от первой команды и content-usage: train-ai=n, search=y от остальных (HTTP/2 приводит имена к нижнему регистру). Пустой вывод значит, что сигнала нет; grep завершится со статусом 1. Первую команду я 2 октября 2026 года запустил на продакшен-сайте aiSiteReady и получил одну строку: Content-Signal: search=yes, ai-input=yes, ai-train=yes. Правила или заголовка Content-Usage там пока нет.
Чтобы увидеть, к какому выводу придёт потребитель, разберите значение так, как описывает драфт, и объедините заявления. Это намеренно упрощённое чтение формата; в продакшене используйте полноценный парсер RFC 9651.
type Pref = "allow" | "disallow" | "unknown";
type Prefs = Record<"train-ai" | "ai-use" | "search", Pref>;
const unknown = (): Prefs => ({ "train-ai": "unknown", "ai-use": "unknown", search: "unknown" });

export function parseUsage(value: string): Prefs {
  const prefs = unknown();
  const seen = new Map<string, string>();
  for (const member of value.split(",")) {
    const [rawKey, rawVal] = member.trim().split("=");
    const key = rawKey.split(";")[0];
    if (/[A-Z]/.test(key)) return unknown(); // ключи чувствительны к регистру: разбор падает
    seen.set(key, (rawVal ?? "").split(";")[0].trim()); // повтор ключа: побеждает последний
  }
  for (const key of Object.keys(prefs) as (keyof Prefs)[]) {
    const v = seen.get(key);
    if (v === "y") prefs[key] = "allow";
    else if (v === "n") prefs[key] = "disallow"; // "no", "yes" и "\"n\"" остаются unknown
  }
  return prefs;
}

// Правило конфликтов по умолчанию: любой disallow побеждает, затем любой allow.
export function combine(...all: Prefs[]): Prefs {
  const out = unknown();
  for (const key of Object.keys(out) as (keyof Prefs)[]) {
    const v = all.map((p) => p[key]);
    out[key] = v.includes("disallow") ? "disallow" : v.includes("allow") ? "allow" : "unknown";
  }
  return out;
}

// robots.txt говорит "train-ai=y, search=y", заголовок говорит "train-ai=n":
console.log(combine(parseUsage("train-ai=y, search=y"), parseUsage("train-ai=n")));
// { 'train-ai': 'disallow', 'ai-use': 'unknown', search: 'allow' }
console.log(parseUsage("train-ai=no, search=y"));
// { 'train-ai': 'unknown', 'ai-use': 'unknown', search: 'allow' }
Я запускал именно этот код, и он печатает показанный вывод. Вот ошибки, которые я проверял бы в первую очередь:
| Ошибка | Что происходит | Исправление |
|---|---|---|
ai-train=n или train-ai=no | Неверный порядок слов в метке или токен значения: неизвестно | Пишите train-ai=n |
Train-AI=N | Ключи и токены чувствительны к регистру: заявление не разбирается | Всё строчными |
train-ai="n" | Строка — не токен: неизвестно | Пишите токен n без кавычек |
| Путь без ведущего слэша | Всё значение читается как заявление и не разбирается: неизвестно | Начинайте пути с / |
Может ли aiSiteReady проверить ваши сигналы использования?
Частично: его проверка content_usage_policy находит Content-Signal, TDMRep, RSL и noai, но Content-Usage пока не находит. На странице методологии эта проверка отнесена к категории Правила для ботов. Подробности ниже взяты из её исходного кода, который я прочитал, пока писал эту статью.
Проверка загружает сканируемую страницу (обычно главную), а также /robots.txt и /.well-known/tdmrep.json. В robots.txt она распознаёт пары Content-Signal и строки RSL License:. Помимо этого она читает валидные записи TDMRep, метатеги TDMRep и заголовки tdm-reservation и tdm-policy; noai и noimageai в метатеге robots или в X-Robots-Tag; связи RSL в Link; а также вендорские заголовки и метатеги политик вроде ai-policy и content-usage-policy.
Один сильный сигнал даёт PASS, только слабые или некорректные дают PARTIAL, а полное отсутствие — FAIL. Проверка оценивает наличие явного объявления, а не то, в какую сторону вы его сделали, так что и резервирование, и разрешение проходят.
В её списке заголовков есть content-usage-policy, имя в стиле вендоров, но нет content-usage от IETF. Строку Content-Usage в robots.txt проверка тоже не читает. Другие проверки robots.txt лишь перечисляют её как неизвестную директиву в своих доказательствах, и на их статус это не влияет.
По моему прочтению кода, сайт, который публикует только aipref, сейчас в отчёте будет показан как сайт без сигналов использования. Поэтому публикуйте рядом распознаваемый сигнал вроде Content-Signal и следите, чтобы они не расходились. Собственный robots.txt aiSiteReady публикует разрешающую строку Content-Signal, и именно она проходит эту проверку на нашем сайте.
Запустите бесплатное сканирование, чтобы увидеть, что из Content-Signal, TDMRep, RSL и noai публикует ваш сайт, какие сигналы слабые и что исправить в первую очередь, на русском, украинском или английском. Сканер работает только на чтение, ходит через SSRF-безопасный загрузчик и не выполняет JavaScript.
Content-Usage позволяет один раз сказать train-ai=n, search=y и привязать это к robots.txt и HTTP-ответам. Это драфт, который никто не обязан соблюдать, поэтому публикуйте его аккуратно, держите в согласии с уже имеющимся Content-Signal и подкрепляйте реальными правилами доступа там, где это важно.
У IMozz 20 лет в разработке ПО, а последний год он строит продукты с помощью LLM. Он развивает aiSiteReady, сканер только для чтения, который проверяет, может ли ИИ-агент прочитать сайт. Сканер серверно рендерит собственный контент как рабочий пример.