Markdown для ИИ-агентов без Cloudflare: nginx, Nuxt, Next.js
Как отдавать Markdown ИИ-агентам без Cloudflare: map в nginx для Accept: text/markdown, код для Nuxt и Next.js, Vary: Accept и curl-скрипт на 9 проверок.
Отдавать Markdown ИИ-агентам на собственном стеке можно, если взять на себя три задачи, которые у Cloudflare решает управляемая функция. Это выбор варианта по Accept: text/markdown, подготовка Markdown и привязка каждого кэша к варианту. Первую и третью в nginx закрывают несколько строк, обработчик в Nuxt или Next.js справляется с первой и второй, а матрица curl-проверок подтверждает все три.
Это сборник рецептов к статье Markdown для ИИ-агентов: content negotiation, где разобраны причины, паттерны отдачи и теория CDN. Здесь вы найдёте рабочие конфиги, настоящее Nuxt-middleware aiSiteReady, способы конвертации и регрессионный скрипт. Тема относится к слою контента в стеке готовности к ИИ-агентам, предполагает, что факты уже лежат в серверно отрендеренном HTML (как сделать JavaScript-сайт читаемым), и закрывает то, на что указывает llms.txt.
Ключевые выводы
- Управляемая функция Cloudflare конвертирует только HTML, на подходящих тарифах, и ограничивает ответ origin размером 2 МБ (документация Cloudflare).
- Своя реализация — это три задачи: выбор варианта с учётом q, источник Markdown и ключ кэша, в который входит вариант.
- nginx может классифицировать
Acceptчерезmap, но не сравнивает q-значения, поэтому рецепт намеренно консервативен (документация nginx).- Собственное Nuxt-middleware aiSiteReady вышло 13 июня 2026 года: настоящая логика q-значений, только GET (на октябрь 2026 года), Markdown строится из тех же источников, что и HTML.
- В Next.js 16 соглашение о файле
middlewareпереименовали вproxy(документация Next.js).
Что делает Markdown for Agents от Cloudflare и что вы заменяете?
Функция конвертирует ваш HTML в Markdown на edge Cloudflare, когда клиент присылает Accept: text/markdown, и на origin ничего менять не нужно. Cloudflare анонсировал её 12 февраля 2026 года (блог Cloudflare). На справочной странице перечислены тарифы Pro, Business и Enterprise, а также клиенты SSL for SaaS, без доплаты; включается в дашборде или через API. Заявленные ограничения: конвертируется только HTML, а ответ origin не может превышать 2 МБ (2 097 152 байта) (документация Cloudflare).
| Что делает Cloudflare | Что строите вы |
|---|---|
Определяет Accept: text/markdown | Проверку с учётом q: в map nginx или в коде приложения |
| Конвертирует HTML на edge | Экспорт при сборке или шаг HTML-в-Markdown |
Ставит text/markdown; charset=utf-8 и добавляет Accept в Vary | Те же заголовки на обоих вариантах |
Добавляет x-markdown-tokens и x-original-tokens | Необязательно и в любом случае приблизительно |
Добавляет Content-Signal: ai-train=yes, search=yes, ai-input=yes, если origin его не задал | Осознанное значение или никакого |
Последняя строка важна: управляемый вариант по умолчанию разрешает обучение и сохраняет ваше значение, если вы его задали. Если отдаёте Markdown сами, никто не напишет эту строку за вас, так что выбирайте сами (предпочтения по использованию контента). Поведение CDN разобрано в прошлой статье; здесь речь только о кэше, который вы держите сами.
Как отдавать Markdown из nginx?
Сверните заголовок Accept в один из двух вариантов через map, а затем по этому варианту выбирайте файл или ключ кэша. map работает в контексте http и перебирает регулярные выражения по порядку, побеждает первое совпадение (документация nginx). Сравнивать q-значения он не умеет, поэтому правило консервативно: Markdown, только если text/markdown указан первым без параметров, кроме q=1. Браузеры, */*, отсутствующий заголовок, text/markdown;q=0 и даже text/markdown; charset=utf-8 получают HTML.
map $http_accept $variant {
    default "html";
    # В кавычках: в шаблоне есть "}" и ";" (правило из документации модуля rewrite nginx).
    "~*^\s*text/markdown\s*(;\s*q=1(\.0{0,3})?\s*)?(,|$)" "md";
}
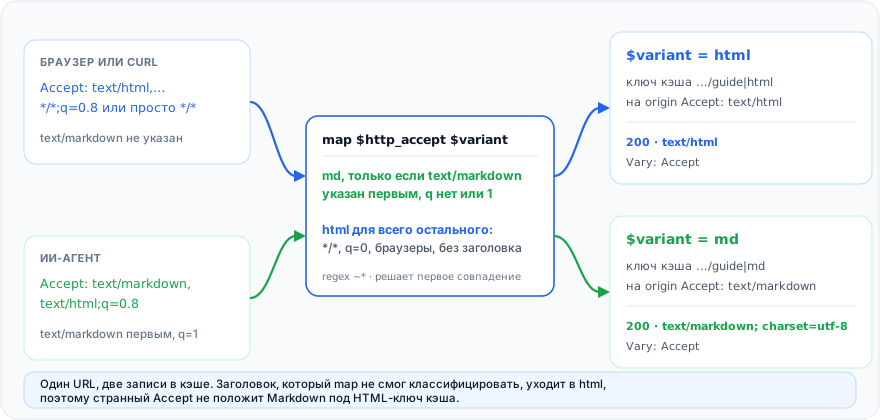
Оба рецепта я проверил 3 октября 2026 года в официальном образе nginx:alpine (nginx 1.31): nginx -t не нашёл ошибок, а скрипт ниже успешно прошёл на рецепте A.
Рецепт A: Markdown-файлы рядом со страницами
Если сборка кладёт index.html и index.md в каждый каталог, nginx отдаёт нужный файл. Поместите это внутрь http, рядом с map выше.
gzip on;
gzip_vary on;
gzip_types text/markdown;               # text/html сжимается всегда; Markdown нужно перечислить

map $variant $index_file {
    md      "index.md";
    default "index.html";
}

server {
    listen 80;
    server_name example.com;
    root /var/www/site;

    # /guide/ превращается в /guide/index.md или /guide/index.html. Если index.md
    # нет, отдаётся HTML-страница, так что согласуемый URL не даёт 404. Ресурсы
    # проходят здесь без изменений: без Vary на CSS, JS и картинках.
    location / {
        index $index_file index.html;
        try_files $uri $uri/ =404;
    }

    # Markdown-файл: запрошен напрямую или попал сюда через redirect от index.
    location ~ \.md$ {
        types { }                                   # здесь mime.types не нужен
        default_type text/markdown;                 # голый тип, чтобы совпал gzip_types
        charset utf-8;
        charset_types text/markdown;                # charset действует только на эти типы
        add_header Vary Accept always;
    }

    # HTML-страницы: Vary и ссылка на Markdown-двойника.
    location ~ ^(?<dir>/(?:.*/)?)index\.html$ {
        add_header Vary Accept always;
        add_header Link "<${dir}index.md>; rel=\"alternate\"; type=\"text/markdown\"" always;
    }
}
Рецепт держится на четырёх деталях:
- Директива
indexпринимает переменные и работает через внутренний redirect, поэтому запрос обрабатывается заново в томlocation, который подходит новому URI (документация nginx). Именно поэтому тип выставляетlocationдля Markdown. - В стандартном
mime.typesнет записи дляmd(проверено в репозитории nginx), так чтоtypes { },default_type text/markdown,charset utf-8иcharset_types text/markdownзадают тип и charset в виде, которыйgzip_typesпо-прежнему распознаёт. Если вписать charset прямо вdefault_type, gzip для Markdown молча отключится. add_headerнаследуется только тогда, когда на текущем уровне нет своих директив, поэтому заголовки уровня server, например HSTS, придётся повторить в этих двухlocation(документация nginx).alwaysсохраняет заголовки на 404, еслиindex.mdнет. Еслиindex.mdесть не во всех каталогах, уберите строкуLinkили отдавайте её только там, где файл существует.gzip_vary onдобавляет вторую строкуVaryсAccept-Encoding. Две строкиVaryдопустимы, потому чтоVary— поле-список и получатель вправе их объединить (RFC 9110); именно такая пара приходит из продакшена aiSiteReady.
Рецепт B: кэш перед приложением
Когда nginx стоит перед Nuxt, Next.js или Express, оба варианта выдаёт приложение, а nginx лишь кэширует их по отдельности. Используйте это для страниц; у JSON API должен быть свой Accept.
proxy_cache_path /var/cache/nginx/pages levels=1:2 keys_zone=pages:10m
                 max_size=512m inactive=30m use_temp_path=off;

map $variant $origin_accept {
    md      "text/markdown";
    default "text/html";
}

upstream app {
    server 127.0.0.1:3000;
    keepalive 16;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://app;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Host $host;
        proxy_set_header Accept $origin_accept;     # origin видит два значения, а не сотни

        proxy_cache pages;
        proxy_cache_key "$scheme://$host$request_uri|$variant";
        proxy_cache_valid 200 5m;
        proxy_cache_valid 404 1m;
        proxy_ignore_headers Vary;                  # ключ по $variant строим сами

        add_header X-Cache-Status $upstream_cache_status always;
    }
}
Зачем игнорировать Vary? Начиная с nginx 1.7.7 он кэширует ответ «с учётом соответствующих полей заголовка запроса» (документация nginx), и каждая отдельная строка Accept от браузеров получила бы свою запись. Ключ по $variant оставляет две.
Цена: если origin варьируется ещё и по Cookie или Accept-Language, добавьте их в ключ или не кэшируйте эти пути. nginx пропускает Vary приложения как есть, так что приложение должно слать Vary: Accept на согласуемых страницах, а не на ресурсах. Ключ по умолчанию, $scheme$proxy_host$request_uri, вообще не содержит варианта; строка proxy_cache_key и есть ваша защита от отравления кэша из прошлой статьи.
Как это делает сервер на Nuxt или Nitro?
Одним серверным middleware, которое отвечает только на явный запрос Markdown, а всё остальное передаёт HTML-рендереру. Это настоящий код aiSiteReady, добавленный 13 июня 2026 года: сначала маркетинговые страницы, в тот же вечер статьи блога. Код начинается с проверок.
// frontend/server/middleware/markdown-negotiation.ts (фрагмент, октябрь 2026)
export default defineEventHandler(async (event) => {
  if (!isGetOrHead(event)) { // HEAD согласуется точно так же, как GET
    return;
  }
  if (!prefersMarkdown(getRequestHeader(event, "accept"))) {
    return;
  }
  const pathname = getRequestURL(event).pathname;
  // ...определить страницу, собрать Markdown, вернуть sendMarkdown(event, markdown)
});
Если ничего не вернуть, запрос уходит дальше: h3 вызывает обработчики по порядку, пока один не вернёт ответ (документация h3). Документация Nuxt описывает middleware как «только смотреть» (документация Nuxt), поэтому возврат значения считайте поведением h3, а не обещанием Nuxt, и закрепите его матрицей ниже. Ответ собирается в одном месте:
function sendMarkdown(event: H3Event, markdown: string): string {
  setResponseHeader(event, "content-type", "text/markdown; charset=utf-8");
  setResponseHeader(event, "vary", "Accept");
  setResponseHeader(event, "cache-control", "public, s-maxage=300, stale-while-revalidate=86400");
  return bodyForMethod(event, markdown); // HEAD: пустое тело, Content-Length как у GET
}
Три решения стоит перенять:
- HTML здесь не конвертируется. Маркетинговые страницы собираются из того же i18n-каталога и той же структуры страниц, что и Vue-компоненты, а
@nuxt/contentхранит статью блога как разобранное дерево, которое небольшой сериализатор записывает обратно в Markdown. Оба представления строятся из одного источника, поэтому они не расходятся. - Всё, на что middleware не может ответить, уходит дальше: неизвестный slug получает честный 404 от рендерера, а сбой запроса к контенту отдаёт HTML, а не 500.
Varyдля HTML-варианта берётся из route rules, так как SSR формирует этот ответ уже после того, как middleware уступило дорогу.
// frontend/nuxt.config.ts (фрагмент: правило маршрута, общее для маркетинговых страниц и статей блога)
headers: {
  "Cache-Control": "public, s-maxage=300, stale-while-revalidate=86400",
  "Vary": "Cookie, Accept-Language, Accept",
},
Ветка для HEAD тоже из первых рук. Первая версия проверяла только GET и отправляла запросы HEAD в HTML-рендерер: 2 октября 2026 года curl -I -H 'Accept: text/markdown' к статье aiSiteReady вернул заголовки text/html, а тот же запрос через GET — text/markdown; charset=utf-8. RFC 9110 говорит, что на HEAD серверу следует отвечать теми заголовками, что дал бы GET (RFC 9110), поэтому проверка теперь пропускает HEAD, а bodyForMethod убирает только тело. Если копируете, выставляйте Content-Length сами: Node не добавляет его в ответ на HEAD, если обработчик не задал его явно.
Как согласовывать Markdown в Next.js?
Используйте файл proxy, чтобы переписывать (rewrite) запросы Markdown на route handler, и добавляйте Vary: Accept к каждому ответу, который он обрабатывает. В Next.js 16.0.0 соглашение о файле middleware объявили устаревшим и переименовали в proxy. NextResponse.rewrite отдаёт другой маршрут под исходным URL, а заголовки ответа выставляются на возвращаемом NextResponse (документация Next.js). В Next.js 15 и более ранних версиях назовите файл middleware.ts, а функцию middleware.
// proxy.ts (корень проекта, рядом с app/)
import { NextResponse, type NextRequest } from "next/server";
import { prefersMarkdown } from "./lib/prefers-markdown";   // функция из раздела про q-значения
import markdownPaths from "./generated/markdown-paths.json"; // создаётся при сборке

const hasMarkdown = new Set<string>(markdownPaths);          // ["/docs/intro", ...]

export function proxy(request: NextRequest) {
  const { pathname } = request.nextUrl;
  const wants =
    (request.method === "GET" || request.method === "HEAD") &&
    prefersMarkdown(request.headers.get("accept")) &&
    hasMarkdown.has(pathname);

  const response = wants
    ? NextResponse.rewrite(new URL(`/api/md${pathname}`, request.url))
    : NextResponse.next();
  response.headers.append("Vary", "Accept");   // append: Next.js может сам задавать значения Vary
  return response;
}

export const config = {
  matcher: ["/((?!api|_next/static|_next/image|.*\\..*).*)"],
};
Целью rewrite служит Route Handler из прошлой статьи. Манифест времени сборки не даёт странице без Markdown-двойника превратиться в 404 для агентов: она уходит в HTML. matcher исключает api, ресурсы _next и всё, у чего есть расширение файла.
Оговорка: aiSiteReady работает на Nuxt, поэтому в отличие от предыдущего раздела этот фрагмент я в продакшене не запускал; он следует документированному API. Next.js умеет сопоставлять и заголовок запроса внутри rewrites(), но регулярное выражение по заголовку не взвесит q-значения, а для Vary нужно отдельное правило headers() (документация Next.js). Прогоните матрицу на своей сборке, прежде чем доверять любому из вариантов.
Конвертировать при сборке или на лету?
Генерируйте Markdown из того же источника, что и HTML, при сборке, если получается; HTML на лету конвертируйте, только когда отрендеренный HTML — единственный источник правды. Результат сборки можно проверить до деплоя, он дёшево кэшируется, а всё, что сгенерировано из источника, не может разойтись со страницей. aiSiteReady держится золотой середины: он рендерит Markdown из источника контента на каждый запрос, без конвертации HTML.
Конвертация на лету — это конвейер: получить HTML, убрать обвязку, сконвертировать, исправить ссылки, закэшировать по URL и варианту. Среднюю часть закрывают три настоящие библиотеки.
- Turndown конвертирует HTML в Markdown в Node и в браузере. По умолчанию он делает setext-заголовки и блоки кода с отступом, поэтому задайте
headingStyle: "atx"иcodeBlockStyle: "fenced", а навигацию уберите черезremove(). - rehype-remark превращает синтаксическое дерево HTML в дерево Markdown в экосистеме unified:
rehype-parse,rehype-remark, затемremark-stringify. - Mozilla Readability вытаскивает основной контент страницы, так что навигация, футер и cookie-баннер до конвертера не доходят. Ей нужен DOM, например jsdom.
import TurndownService from "turndown";

const turndown = new TurndownService({ headingStyle: "atx", codeBlockStyle: "fenced" });
turndown.remove(["script", "style", "nav", "footer", "form"]);

export const htmlToMarkdown = (html: string) => turndown.turndown(html);

// Грубая оценка размера для логов или заголовка с числом токенов. Это не токенизатор.
export const estimateTokens = (text: string) => Math.ceil(text.length / 4);
Любое число токенов — приближение. Cloudflare называет свои заголовки оценкой, а документация Anthropic называет оценкой собственный подсчёт и отмечает, что новый токенизатор даёт примерно на 30 процентов больше токенов на тот же ввод, чем прежние модели (документация Anthropic). Деление числа символов на четыре — это ориентир, а не обещание. Конвертация на лету к тому же наследует ограничения HTML: если факты подгружаются клиентским JavaScript, ни один конвертер их не найдёт.
Какие ошибки с q-значениями ломают content negotiation?
Почти все они происходят от того, что Accept воспринимают как строку для поиска, а не как список диапазонов с весами. RFC 9110 определяет вес так: по умолчанию 1, при 0,001 тип наименее предпочтителен, а 0 означает «неприемлемо» (RFC 9110).
| Ошибка | Пример Accept | Правильный ответ |
|---|---|---|
| Поиск подстроки | text/markdown;q=0 | HTML: ноль значит отказ |
| Wildcard принят за согласие | */* (значение curl по умолчанию) | HTML |
| Строки браузеров | text/html,…,*/*;q=0.8 | HTML |
| Markdown с меньшим весом | text/markdown;q=0.5, text/html;q=0.9 | HTML |
| Регистр и пробелы | Text/Markdown ; q=1 | Markdown |
| Ничего не подходит | application/json | HTML по политике или 406 |
| Равные веса | text/html, text/markdown | На ваше усмотрение; проверьте |
Токен в Vary | Vary: Accept-Encoding | Это не Accept: сравнивайте токены целиком |
Медиатипы нечувствительны к регистру, запрос без Accept не выражает предпочтений, а когда ничего не подходит, сервер может ответить 406 или проигнорировать заголовок (RFC 9110). Для URL страницы, которую открывают и браузеры, безопаснее вернуть HTML. Ничья тоже вопрос политики, раз RFC не задаёт правила для равных весов: middleware aiSiteReady при любой ничьей отдаёт Markdown, а правило nginx следует порядку в списке, поэтому text/markdown, text/html получает Markdown, а text/html, text/markdown — HTML.
Вот правило в виде кода: у text/markdown вес должен быть больше нуля и не меньше веса text/html и wildcard. Я сравнил эту сжатую версию с той, что работает в aiSiteReady, на 200 000 случайных строк Accept и расхождений не нашёл.
export function prefersMarkdown(accept: string | null | undefined): boolean {
  if (!accept) return false;
  const best = new Map<string, number>();            // медиатип -> наибольший указанный q
  for (const part of accept.split(",")) {
    const [type, ...params] = part.split(";").map((s) => s.trim());
    if (!type) continue;
    let q = 1;
    for (const param of params) {
      const [name, value] = param.split("=").map((s) => s.trim());
      const n = Number.parseFloat(value ?? "");
      if (name?.toLowerCase() === "q" && !Number.isNaN(n)) q = Math.min(1, Math.max(0, n));
    }
    const key = type.toLowerCase();
    best.set(key, Math.max(best.get(key) ?? 0, q));
  }
  const md = best.get("text/markdown") ?? 0;
  return md > 0 && md >= (best.get("text/html") ?? 0) && md >= (best.get("*/*") ?? 0);
}
text/* игнорируется намеренно, поэтому клиент, приславший только text/*, получит HTML. Но клиент, у которого text/* весит больше text/markdown, всё равно получит Markdown; если нужно строгое поведение по RFC 9110, сравнивайте и с text/*.
Как проверить согласование по Accept через curl?
Запросите один URL с фиксированным набором заголовков Accept и проверьте статус, Content-Type и токены Vary каждого ответа. Используйте GET, а не curl -I, и проверяйте публичный URL, чтобы кэш по дороге тоже участвовал в тесте.
Accept запроса | Ожидаемый Content-Type | Статус | Vary |
|---|---|---|---|
text/markdown | text/markdown; charset=utf-8 | 200 | есть Accept |
text/markdown, text/html;q=0.8 | text/markdown; charset=utf-8 | 200 | есть Accept |
text/markdown,*/*;q=0.1 (сканер aiSiteReady) | text/markdown; charset=utf-8 | 200 | есть Accept |
Строка браузера, */* или без заголовка | text/html | 200 | есть Accept |
text/markdown;q=0 | text/html | 200 | есть Accept |
text/markdown;q=0.5, text/html;q=0.9 | text/html | 200 | есть Accept |
application/json | text/html (политика fallback) | 200 | есть Accept |
| Любой, на несуществующем URL | не Markdown | 404 | есть Accept (приложение); статический сервер может его не ставить |
Скрипт покрывает эти строки девятью проверками Accept. Он сравнивает Vary по токенам целиком, потому что в Accept-Encoding есть буквы Accept, и предупреждает, когда HEAD расходится с GET. Передавайте итоговый URL, например /guide/ для рецепта A: скрипт не следует редиректам, а для несуществующего URL проверяет только статус.
#!/usr/bin/env bash
# использование: ./check-negotiation.sh https://example.com/guide/ [https://example.com/no-such-page]
set -u
URL="${1:?usage: $0 URL [MISSING_URL]}"; MISSING="${2:-}"
BODY="$(mktemp)"; trap 'rm -f "$BODY"' EXIT; fails=0

vary_has_accept() { tr ',' '\n' | sed 's/^ *//; s/ *$//' | grep -qix 'accept'; }

check() {  # метка | значение Accept ("" — не слать) | ожидаемый медиатип
  local label="$1" accept="$2" want="$3" hdrs status ctype problems=""
  local args=(-sS -D - -o "$BODY")
  if [ -n "$accept" ]; then args+=(-H "Accept: $accept"); else args+=(-H 'Accept:'); fi
  hdrs="$(curl "${args[@]}" "$URL" | tr -d '\r')" || { echo "FAIL  $label: request failed"; fails=$((fails+1)); return; }
  status="$(printf '%s\n' "$hdrs" | head -1 | awk '{print $2}')"
  ctype="$(printf '%s\n' "$hdrs" | grep -i '^content-type:' | head -1 | sed 's/^[^:]*: *//' | tr 'A-Z' 'a-z')"
  [ "$status" = 200 ] || problems="$problems status=$status"
  case "$ctype" in "$want"*) ;; *) problems="$problems content-type=[$ctype]" ;; esac
  printf '%s\n' "$hdrs" | grep -i '^vary:' | sed 's/^[^:]*: *//' | vary_has_accept \
    || problems="$problems missing-Vary-Accept"
  if [ "$want" = "text/markdown" ]; then
    case "$ctype" in *charset=utf-8*) ;; *) problems="$problems missing-charset" ;; esac
    head -c 2000 "$BODY" | grep -qiE '<!doctype|<html' && problems="$problems body-is-html"
  fi
  if [ -z "$problems" ]; then echo "ok    $label"; else echo "FAIL  $label:$problems"; fails=$((fails+1)); fi
}

check 'markdown only'        'text/markdown'                         text/markdown
check 'markdown, html q=0.8' 'text/markdown, text/html;q=0.8'        text/markdown
check 'aiSiteReady scanner'  'text/markdown,*/*;q=0.1'               text/markdown
check 'browser'              'text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8' text/html
check 'curl default */*'     '*/*'                                   text/html
check 'no Accept header'     ''                                      text/html
check 'markdown refused'     'text/markdown;q=0'                     text/html
check 'html preferred'       'text/markdown;q=0.5, text/html;q=0.9'  text/html
check 'json only'            'application/json'                      text/html

head_type="$(curl -sS -I -H 'Accept: text/markdown' "$URL" | tr -d '\r' | grep -i '^content-type:' | head -1 | sed 's/^[^:]*: *//')"
case "$head_type" in text/markdown*) echo "ok    HEAD mirrors GET" ;; *) echo "WARN  HEAD returned [$head_type]" ;; esac

if [ -n "$MISSING" ]; then
  code="$(curl -sS -o /dev/null -w '%{http_code}' -H 'Accept: text/markdown' "$MISSING")"
  case "$code" in 404|410) echo "ok    missing page -> $code" ;; *) echo "FAIL  missing page -> $code"; fails=$((fails+1)) ;; esac
fi
[ "$fails" -eq 0 ] && echo PASS || { echo "$fails check(s) failed"; exit 1; }
Я прогнал его на локальном сервере в трёх сломанных режимах. Проверка подстроки по Accept проваливает проверки q=0 и «html preferred»; сервер, отдающий только Vary: Accept-Encoding, проваливает все проверки; обработчик только для GET проходит с предупреждением про HEAD. На статье aiSiteReady 2 октября 2026 года прошли все девять проверок Accept, несуществующая статья вернула 404, а строка про HEAD выдала предупреждение. После исправления HEAD эта строка выглядит как ok HEAD mirrors GET.
Какой подход выбрать?
Если вы уже проксируете через Cloudflare и ваш HTML подходит, включите управляемую функцию; на своём сервере экспортируйте Markdown при сборке, согласуйте вариант в nginx и публикуйте .md-соседей в придачу. В остальном выбирайте по тому, кому принадлежит сервер и откуда берётся Markdown.
| Вариант | Выбирайте, когда | Что остаётся вам |
|---|---|---|
| Управляемая конвертация (Cloudflare) | Вы уже проксируете через него на подходящем тарифе | Решение про Content-Signal |
Экспорт при сборке плюс map в nginx | Статический или Markdown-first сайт на вашем сервере | Шаг сборки, ключ кэша |
| Рендер из источника на каждый запрос (aiSiteReady) | Источник лежит в CMS или @nuxt/content | Сериализатор, Vary, ключ кэша |
| На лету в приложении | Отрендеренный HTML — единственный источник | Конвертер, тесты, CPU |
Только .md-соседи | Статический хостинг, неизвестный CDN | Дубли URL |
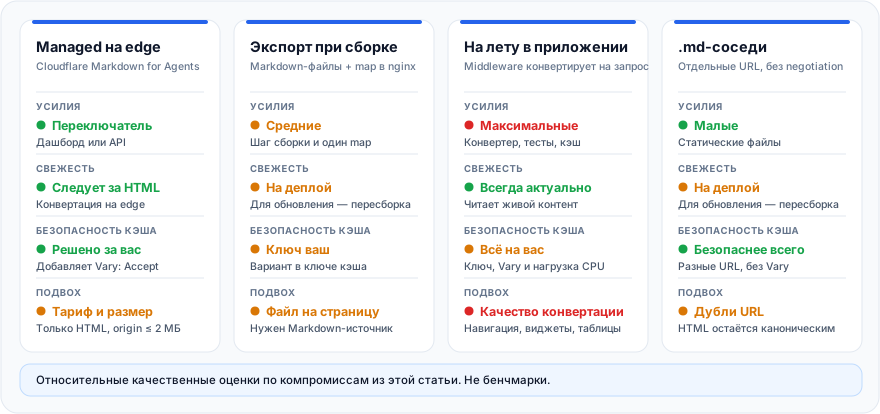
Для контентного сайта на собственном сервере эта связка из Markdown при сборке, согласования в nginx и .md-соседей — мой выбор по умолчанию. Соседи нужны, чтобы клиент, который никогда не шлёт Accept: text/markdown, всё равно мог забрать файл. Предложение llms.txt допускает page.md или page.html.md, а для URL каталогов index.md или index.html.md (llmstxt.org). Запасная проба aiSiteReady делает один запрос: page.md для URL страницы, index.html.md для URL каталога.
Как проверка Markdown в aiSiteReady оценивает страницу?
Проверка markdown_negotiation в aiSiteReady запрашивает страницу так, как это сделал бы агент, и оценивает ответ как PASS, PARTIAL, FAIL или UNKNOWN, с доказательствами. У неё высокая серьёзность и вес 2,0 внутри категории Доступность контента, а эта категория даёт 25% оценки (40% в профиле Контентный сайт). Канонический URL запрашивается с Accept: text/markdown,*/*;q=0.1 через SSRF-безопасный fetcher, JavaScript не выполняется. Только если этот запрос не прошёл, проверка запрашивает .md-URL в стиле llms.txt.
- PASS:
Content-Typeровноtext/markdown, тело похоже на Markdown, и естьVary: Acceptлибо объявленныйLink: rel="alternate"; type="text/markdown". Соседний URL с Markdown проходит и безVary. - PARTIAL: устаревший тип
text/x-markdown, Markdown безVaryиLink,Link: rel="alternate"; type="text/markdown"на ответе, который не является Markdown (цель ссылки сканер не запрашивает), либо HTML сVary: Accept. Любой другой признак Markdown, например похожее на Markdown тело с другим типом, тоже даёт PARTIAL. - FAIL: ни в одном из ответов нет признаков Markdown либо ответ не 2xx. Исключение: 403 и 429 дают UNKNOWN, потому что блокировка бота — не вердикт; так же трактуются таймауты и тела больше 2 МБ.
«Похоже на Markdown» означает минимум два признака (заголовок, ссылка, список, блок кода, отсутствие HTML-тегов) и не больше трёх HTML-тегов (до четверти строк, если ответ отдан как text/markdown).
Эта эвристика сыграла против нас: когда блог начал отдавать text/markdown, одна техническая статья оценилась как не-Markdown из-за 32 тегоподобных строк, и все они были в примерах кода. Исправление сканера в тот же вечер, 13 июня 2026 года, научило его игнорировать теги внутри fenced- и inline-кода; теги в прозе по-прежнему считаются.
Точные веса описаны на странице методологии; проверка Markdown стоит рядом с llms.txt в слое доступности контента из статьи что значит готовность к ИИ-агентам. Запустите бесплатное сканирование, чтобы увидеть, отдаёт ли ваш сервер настоящий Markdown на Accept: text/markdown, какого заголовка не хватает и что исправить первым, — на английском, украинском или русском.
Если коротко: Markdown для агентов на своём сервере — это три задачи, а не платформа. Выберите вариант по Accept с учётом q, подготовьте Markdown из источника, который у вас уже есть, и сделайте так, чтобы каждый кэш между вами и агентом знал: у одного URL два представления.
У IMozz 20 лет в разработке ПО, а последний год он строит продукты с помощью LLM. Он развивает aiSiteReady, сканер только для чтения, который проверяет, может ли ИИ-агент прочитать сайт. Сканер серверно рендерит собственный контент как рабочий пример.